La privacy prima di tutto
I file caricati vengono eliminati automaticamente e in modo permanente entro due ore.
Eliminazione automatica

Sviluppato da ingegneri con oltre 10 anni di esperienza in infrastrutture su larga scala, sistemi dati e calcolo scientifico. Progettato per flussi di lavoro audio reali in cui contano privacy, elaborazione affidabile e usabilità pratica.
I file caricati vengono eliminati automaticamente e in modo permanente entro due ore.
Valutato 5 stelle su Trustpilot per velocità, affidabilità e facilità d'uso.
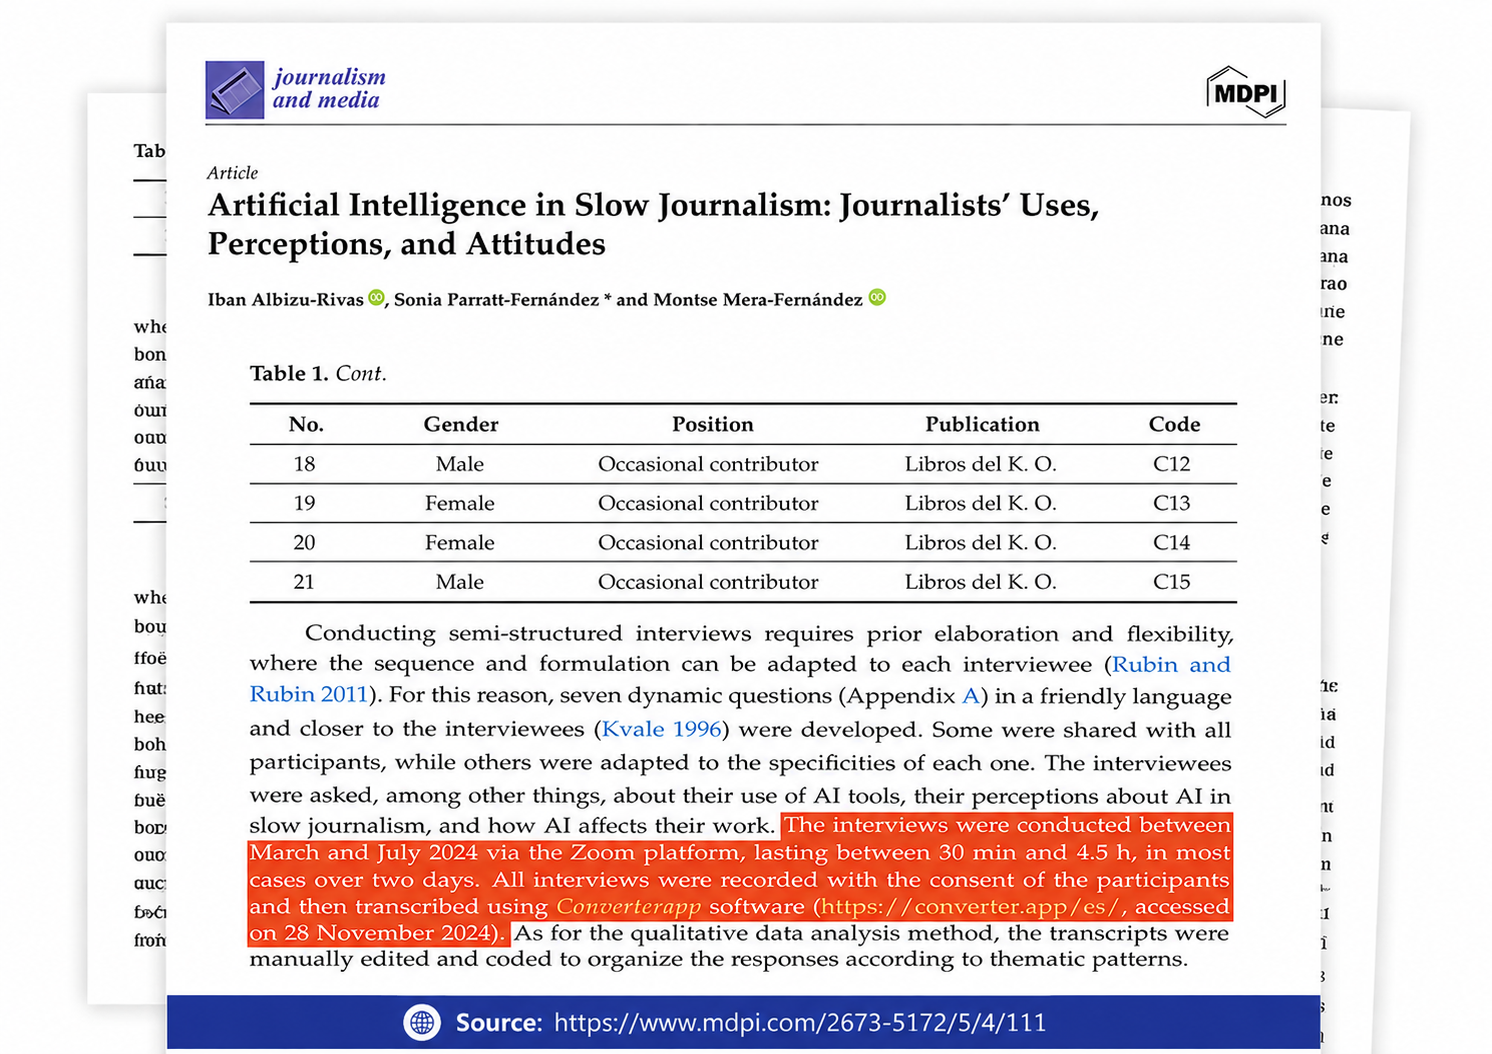
Citato in ricerche pubblicate e utilizzato per la trascrizione di interviste e l’analisi qualitativa dei dati.
Il browser registra il microfono come audio Opus (Chrome, Firefox, Edge) o AAC (Safari) e lo conserva in memoria. Quando Lei conferma, il file viene caricato tramite HTTPS su uno dei nostri server di trascrizione.
Qui, ffmpeg decodifica l'audio e Whisper – un modello open source di riconoscimento vocale – lo trasforma in testo in un unico passaggio, includendo punteggiatura e interruzioni di frase. Se il rilevamento degli interlocutori è attivo, un modello di diarizzazione divide prima l'audio per interlocutore e la trascrizione viene annotata di conseguenza.
La trascrizione viene prima scritta come testo e poi impaginata come PDF con LibreOffice: un semplice documento stampabile con testo selezionabile, senza scansioni né immagini. La pagina dei risultati consente di scaricarlo; l'audio e la trascrizione vengono eliminati automaticamente in seguito.
Il riconoscimento vocale è efficace solo quanto lo è l'audio. Tre fattori fanno la differenza maggiore: distanza, rumore e sovrapposizione. Tenga il microfono a 10–20 cm dalla bocca; uno smartphone tenuto vicino è migliore di un laptop dall'altro lato del tavolo. Spenga le ventole, chiuda la finestra ed eviti stanze con forte eco.
Parli a un ritmo normale e completi le frasi: il modello utilizza il contesto, quindi frasi a metà e parole riempitive producono un testo peggiore rispetto a un parlato completo, anche se leggermente più lento. Per le interviste, chieda alle persone di non parlare una sopra l'altra; il parlato sovrapposto è il caso più difficile per qualsiasi sistema di riconoscimento.
Ascolti l'anteprima prima di iniziare. Se l'indicatore del livello si muove appena o resta costantemente al massimo, registri di nuovo invece di sperare che la trascrizione risulti corretta.
Questo strumento è utilizzato da insegnanti, podcaster, giornalisti e da chiunque riesca a formulare i pensieri più velocemente a voce che con la tastiera: per redigere un'e-mail o un articolo parlando, acquisire i verbali delle riunioni, trasformare una lezione o un promemoria vocale in appunti ricercabili, trascrivere le risposte a un'intervista per scopi di ricerca e ottenere una versione leggibile di un messaggio vocale che al momento non può essere riprodotto.
Poiché Whisper rileva automaticamente la lingua, la stessa pagina funziona per una dettatura in tedesco, una nota vocale in spagnolo o una lezione in inglese senza alcuna impostazione. La trascrizione non viene tradotta: viene scritta nella lingua parlata.
Per audio già disponibili come file – podcast, lezioni, chiamate – i convertitori da audio a testo e da MP3 a testo di questo sito utilizzano lo stesso motore con le stesse opzioni.
Non traduce: le trascrizioni sono nella lingua parlata. Non genera tempistiche per i sottotitoli: per i file SRT o VTT utilizzi i convertitori di sottotitoli disponibili su questo sito. Non identifica i relatori per nome, ma solo in base al cambio di relatore quando il rilevamento dei relatori è attivo. Inoltre, non può recuperare parole non udibili nella registrazione.
Nomi propri, nomi di prodotti e abbreviazioni poco comuni sono gli errori più frequenti; in genere, per una registrazione nitida, è sufficiente una rapida rilettura del risultato tenendo conto di questi elementi.