La privacy prima di tutto
I file caricati vengono eliminati automaticamente e in modo permanente entro due ore.
Eliminazione automatica

Sviluppato da ingegneri con oltre 10 anni di esperienza in infrastrutture su larga scala, sistemi dati e calcolo scientifico. Progettato per flussi di lavoro audio reali in cui contano privacy, elaborazione affidabile e usabilità pratica.
I file caricati vengono eliminati automaticamente e in modo permanente entro due ore.
Valutato 5 stelle su Trustpilot per velocità, affidabilità e facilità d'uso.
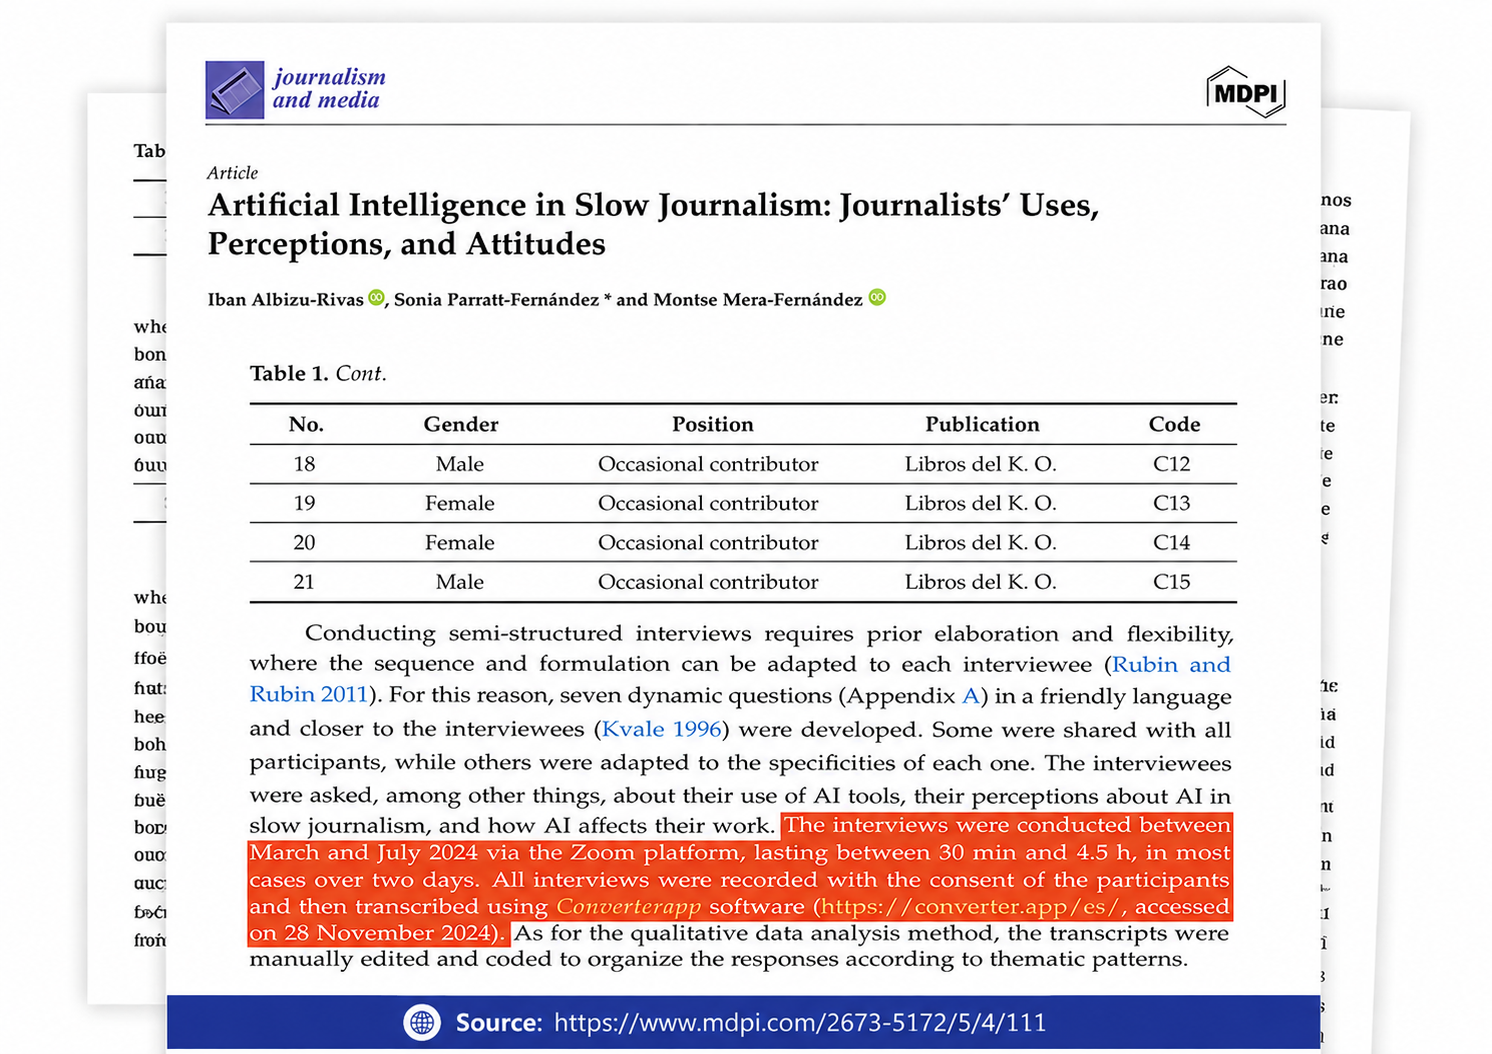
Citato in ricerche pubblicate e utilizzato per la trascrizione di interviste e l’analisi qualitativa dei dati.
Il browser registra l'audio dal microfono in formato Opus (Chrome, Firefox, Edge) o AAC (Safari) e lo mantiene in memoria. Quando si conferma, il file viene caricato tramite HTTPS su uno dei nostri server di trascrizione.
Qui, ffmpeg decodifica l'audio e Whisper – un modello open source per il riconoscimento vocale – lo trasforma in testo in un unico passaggio, includendo punteggiatura e separazioni tra le frasi. Se il rilevamento degli interlocutori è attivo, un modello di diarizzazione suddivide prima l'audio per interlocutore e la trascrizione viene annotata di conseguenza.
La trascrizione viene salvata come file di testo semplice UTF 8 con punteggiatura normale e separazioni tra i paragrafi, quindi può essere aperta con qualsiasi editor, programma di videoscrittura o app per le note e incollata ovunque. La pagina dei risultati consente di scaricarla; l'audio e la trascrizione vengono eliminati automaticamente in seguito.
Il riconoscimento vocale è valido solo quanto l'audio. Tre fattori fanno la differenza maggiore: distanza, rumore e sovrapposizione. Tenga il microfono a 10–20 cm dalla bocca; un telefono tenuto vicino funziona meglio di un laptop dall'altra parte del tavolo. Spenga i ventilatori, chiuda la finestra ed eviti stanze con forte eco.
Parli a un ritmo normale e completi le frasi: il modello usa il contesto, quindi frasi a metà e parole riempitive producono un testo peggiore rispetto a un parlato completo, anche se leggermente più lento. Per le interviste, chieda alle persone di non parlare una sopra l'altra; il parlato sovrapposto è il caso più difficile per qualsiasi sistema di riconoscimento.
Ascolti l'anteprima prima di iniziare. Se il misuratore del livello si muove appena o resta costantemente al massimo, registri di nuovo invece di sperare che la trascrizione risulti corretta.
Questo strumento è usato da insegnanti, podcaster, giornalisti e da chiunque riesca a formulare i pensieri più velocemente parlando che scrivendo alla tastiera: per redigere un'e-mail o un articolo a voce, acquisire i verbali delle riunioni, trasformare una lezione o un memo vocale in appunti ricercabili, trascrivere le risposte alle interviste per la ricerca e ottenere una versione leggibile di un messaggio vocale che al momento non è possibile ascoltare.
Poiché Whisper rileva automaticamente la lingua, la stessa pagina funziona per un dettato in tedesco, una nota vocale in spagnolo o una lezione in inglese senza alcuna impostazione. La trascrizione non viene tradotta: viene scritta nella lingua parlata.
Per l'audio già disponibile come file – podcast, lezioni, chiamate – i convertitori da audio a testo e da MP3 a testo di questo sito utilizzano lo stesso motore con le stesse opzioni.
Non traduce: le trascrizioni sono nella lingua parlata. Non genera tempi per i sottotitoli: per i file SRT o VTT utilizzi i convertitori di sottotitoli presenti su questo sito. Non identifica gli interlocutori per nome, ma solo in base al cambio di interlocutore quando il rilevamento degli interlocutori è attivo. Inoltre, non può recuperare parole non udibili nella registrazione.
I nomi propri, i nomi dei prodotti e le abbreviazioni rare sono gli errori più frequenti; di solito, per una registrazione pulita, è sufficiente rileggere rapidamente il risultato prestando attenzione a questi elementi.