Confidențialitatea pe primul loc
Fișierele încărcate sunt șterse automat și permanent în decurs de două ore.
Ștergere automată

Dezvoltat de ingineri cu peste 10 ani de experiență în infrastructură la scară largă, sisteme de date și calcul științific. Proiectat pentru fluxuri de lucru audio din lumea reală, unde confidențialitatea, procesarea fiabilă și utilizarea practică sunt importante.
Fișierele încărcate sunt șterse automat și permanent în decurs de două ore.
Evaluat cu 5 stele pe Trustpilot pentru viteză, fiabilitate și ușurință în utilizare.
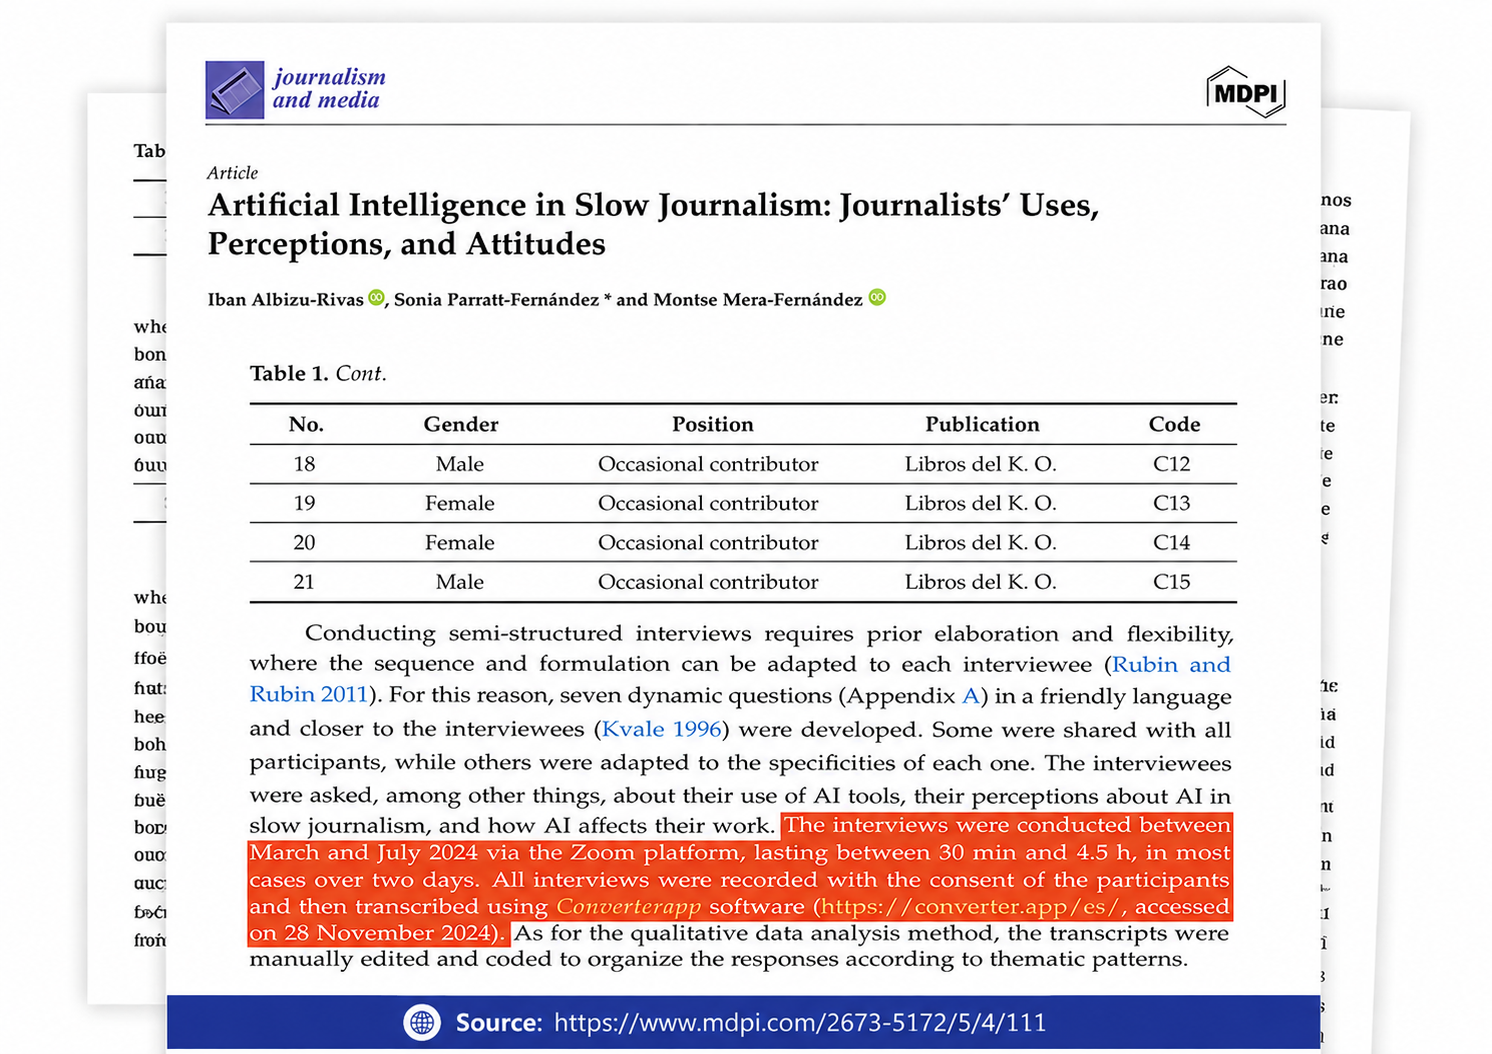
Menționat în cercetări publicate și utilizat pentru transcrierea interviurilor și analiza calitativă a datelor.
Browserul dvs. înregistrează microfonul ca fișier audio Opus (Chrome, Firefox, Edge) sau AAC (Safari) și îl păstrează în memorie. Când confirmați, fișierul este încărcat prin HTTPS pe unul dintre serverele noastre de transcriere.
Acolo, ffmpeg decodează fișierul audio, iar Whisper – un model open-source de recunoaștere vocală – îl transformă în text dintr-o singură trecere, inclusiv cu punctuație și separarea propozițiilor. Dacă detectarea vorbitorilor este activată, un model de diarizare împarte mai întâi fișierul audio după vorbitor, iar transcrierea este adnotată în consecință.
Transcrierea este salvată ca fișier text simplu UTF 8, cu punctuație normală și paragrafe, astfel încât să poată fi deschisă în orice editor, procesor de text sau aplicație de notițe și lipită oriunde. Pagina cu rezultate vă permite să o descărcați; fișierul audio și transcrierea sunt șterse automat ulterior.
Recunoașterea vocală este la fel de bună ca sunetul. Trei aspecte fac cea mai mare diferență: distanța, zgomotul și suprapunerea vocilor. Țineți microfonul la 10–20 cm de gură; un telefon ținut aproape este mai bun decât un laptop aflat de cealaltă parte a mesei. Opriți ventilatoarele, închideți fereastra și evitați încăperile cu ecou puternic.
Vorbiți într-un ritm normal și terminați propozițiile – modelul folosește contextul, astfel că propozițiile incomplete și cuvintele de umplutură produc un text mai slab decât vorbirea completă, ușor mai lentă. Pentru interviuri, rugați participanții să nu vorbească unii peste alții; vorbirea suprapusă este cel mai dificil caz pentru orice sistem de recunoaștere vocală.
Ascultați previzualizarea înainte de a începe. Dacă indicatorul de nivel abia se mișcă sau rămâne constant la nivel maxim, înregistrați din nou în loc să sperați că transcrierea va ieși corect.
Acest instrument este folosit de profesori, podcasteri, jurnaliști și de oricine gândește mai repede cu voce tare decât la tastatură: pentru redactarea unui e-mail sau articol prin vorbire, consemnarea minutelor unei ședințe, transformarea unei prelegeri sau a unei note vocale în notițe care pot fi căutate, transcrierea răspunsurilor din interviuri pentru cercetare și obținerea unei versiuni lizibile a unui mesaj vocal care nu poate fi redat momentan.
Deoarece Whisper detectează automat limba, aceeași pagină funcționează pentru o dictare în germană, o notă vocală în spaniolă sau o prelegere în engleză, fără nicio setare. Transcrierea nu este tradusă – este scrisă în limba vorbită.
Pentru fișiere audio existente deja – podcasturi, prelegeri, apeluri – convertoarele audio în text și MP3 în text de pe acest site folosesc același motor, cu aceleași opțiuni.
Nu traduce: transcrierile sunt în limba vorbită. Nu generează marcaje temporale pentru subtitrări – pentru fișiere SRT sau VTT, utilizați convertoarele de subtitrări de pe acest site. Nu identifică vorbitorii după nume, ci doar detectează schimbarea vorbitorului atunci când detectarea vorbitorilor este activată. De asemenea, nu poate recupera cuvintele care nu se aud în înregistrare.
Numele proprii, denumirile de produse și abrevierile rare sunt cele mai frecvente erori; de obicei, o verificare rapidă a rezultatului, avându-le în vedere, este singura editare necesară pentru o înregistrare clară.