Privasi Utama
File yang diunggah akan dihapus secara otomatis dan permanen dalam waktu dua jam.
Penghapusan otomatis

Dikembangkan oleh para insinyur dengan pengalaman lebih dari 10 tahun dalam infrastruktur skala besar, sistem data, dan komputasi ilmiah. Dirancang untuk alur kerja audio dunia nyata yang mengutamakan privasi, pemrosesan yang andal, dan kemudahan penggunaan yang praktis.
File yang diunggah akan dihapus secara otomatis dan permanen dalam waktu dua jam.
Dinilai 5 bintang di Trustpilot karena kecepatan, keandalan, dan kemudahan penggunaan.
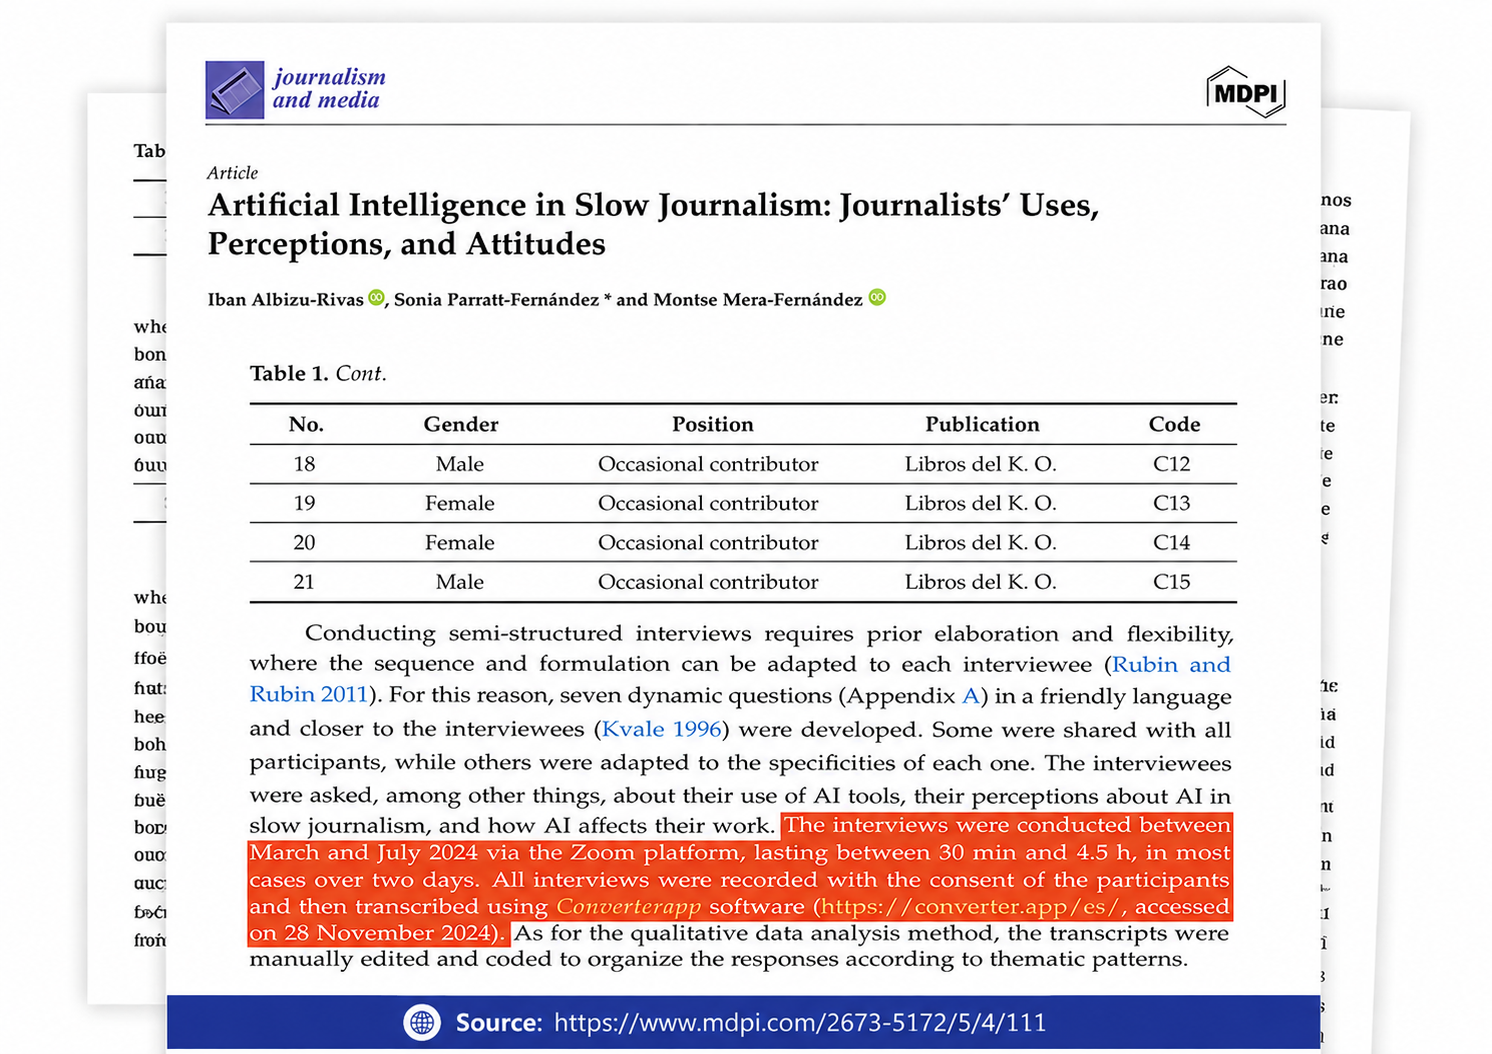
Dirujuk dalam penelitian yang telah dipublikasikan dan digunakan untuk transkripsi wawancara dan analisis data kualitatif.
Browser Anda merekam audio dari mikrofon sebagai audio Opus (Chrome, Firefox, Edge) atau AAC (Safari) dan menyimpannya di memori. Saat Anda mengonfirmasi, file diunggah melalui HTTPS ke salah satu server transkripsi kami.
Di sana, ffmpeg mendekode audio dan Whisper – model pengenalan ucapan sumber terbuka – mengubahnya menjadi teks dalam satu kali proses, termasuk tanda baca dan pemisah kalimat. Jika deteksi pembicara diaktifkan, model pemisahan pembicara terlebih dahulu membagi audio berdasarkan pembicara, lalu transkrip diberi anotasi sesuai pembicara.
Transkrip disimpan sebagai file teks UTF 8 biasa dengan tanda baca dan jeda paragraf normal, sehingga dapat dibuka di editor, pengolah kata, atau aplikasi catatan apa pun serta ditempelkan di mana saja. Halaman hasil memungkinkan Anda mengunduhnya; audio dan transkrip akan dihapus secara otomatis setelahnya.
Pengenalan suara hanya sebaik kualitas audionya. Tiga hal yang paling berpengaruh adalah jarak, kebisingan, dan tumpang tindih suara. Jaga jarak mikrofon 10–20 cm dari mulut Anda; ponsel yang dipegang dekat lebih baik daripada laptop di seberang meja. Matikan kipas angin, tutup jendela, dan hindari ruangan dengan gema yang kuat.
Bicaralah dengan kecepatan normal dan selesaikan kalimat – model menggunakan konteks, sehingga kalimat yang terputus dan kata pengisi menghasilkan teks yang lebih buruk daripada ucapan lengkap dengan tempo sedikit lebih lambat. Untuk wawancara, mintalah orang-orang untuk tidak berbicara bersamaan; suara yang tumpang tindih adalah kasus tersulit bagi sistem pengenal suara apa pun.
Dengarkan pratinjau sebelum memulai. Jika pengukur level hampir tidak bergerak atau terus-menerus berada pada tingkat penuh, rekam ulang daripada berharap transkripnya akan keluar dengan benar.
Alat ini digunakan oleh guru, podcaster, jurnalis, dan siapa saja yang berpikir lebih cepat saat berbicara daripada mengetik: menyusun email atau artikel dengan berbicara, membuat notulen rapat, mengubah kuliah atau rekaman suara menjadi catatan yang dapat dicari, mentranskripsikan jawaban wawancara untuk penelitian, serta mendapatkan versi yang mudah dibaca dari pesan suara yang tidak dapat diputar saat ini.
Karena Whisper mendeteksi bahasa secara otomatis, halaman yang sama dapat digunakan untuk dikte bahasa Jerman, catatan suara berbahasa Spanyol, atau kuliah berbahasa Inggris tanpa pengaturan apa pun. Transkrip tidak diterjemahkan – transkrip ditulis dalam bahasa yang diucapkan.
Untuk audio yang sudah tersedia sebagai file – podcast, kuliah, panggilan – konverter audio ke teks dan MP3 ke teks di situs ini menggunakan mesin yang sama dengan opsi yang sama.
Alat ini tidak menerjemahkan: transkrip dibuat dalam bahasa yang digunakan saat berbicara. Alat ini tidak menghasilkan penanda waktu subtitle – untuk file SRT atau VTT, gunakan konverter subtitle di situs ini. Alat ini tidak mengidentifikasi pembicara berdasarkan nama, hanya berdasarkan pergantian pembicara saat deteksi pembicara diaktifkan. Alat ini juga tidak dapat memulihkan kata-kata yang tidak terdengar dalam rekaman.
Nama diri, nama produk, dan singkatan yang jarang digunakan merupakan kesalahan yang paling sering terjadi; biasanya, rekaman yang jernih hanya memerlukan pembacaan cepat pada hasilnya dengan memperhatikan hal-hal tersebut.