Pirmiausia privatumas
Įkelti failai automatiškai ir visam laikui ištrinami per dvi valandas.
Automatinis ištrynimas

Sukurta inžinierių, turinčių daugiau nei 10 metų patirties didelio masto infrastruktūros, duomenų sistemų ir mokslinio skaičiavimo srityse. Sukurta realaus pasaulio garso darbo eigoms, kur svarbūs privatumas, patikimas apdorojimas ir praktiškas naudojimas.
Įkelti failai automatiškai ir visam laikui ištrinami per dvi valandas.
Įvertinta 5 žvaigždutėmis Trustpilot už greitį, patikimumą ir naudojimo paprastumą.
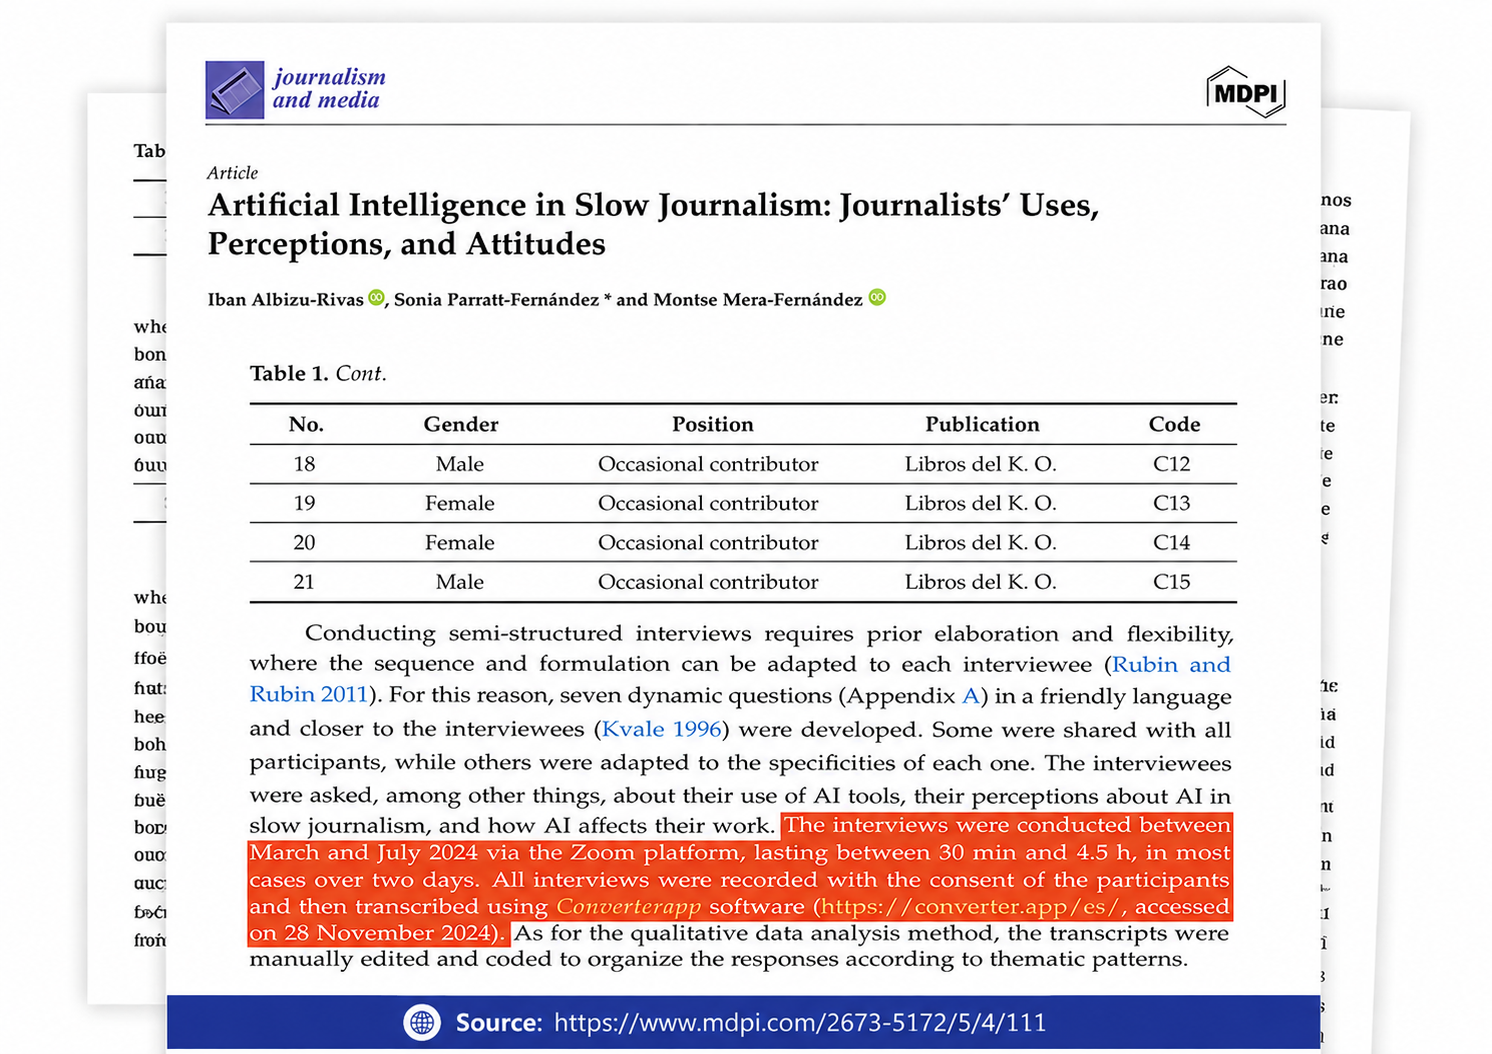
Nurodyta publikuotuose moksliniuose tyrimuose ir naudojama interviu transkripcijai ir kokybinių duomenų analizei.
Jūsų naršyklė įrašo mikrofono garsą kaip Opus garso įrašą (Chrome, Firefox, Edge) arba AAC (Safari) ir laiko jį atmintyje. Patvirtinus, failas per HTTPS įkeliamas į vieną iš mūsų transkribavimo serverių.
Ten ffmpeg iškoduoja garsą, o Whisper – atvirojo kodo kalbos atpažinimo modelis – vienu etapu paverčia jį tekstu, įskaitant skyrybos ženklus ir sakinių lūžius. Jei įjungtas kalbėtojų aptikimas, diarizacijos modelis pirmiausia suskirsto garsą pagal kalbėtojus, o nuorašas atitinkamai pažymimas.
Nuorašas išsaugomas kaip paprastojo UTF 8 teksto failas su įprastais skyrybos ženklais ir pastraipų lūžiais, todėl jį galima atidaryti bet kuriame teksto redaktoriuje, tekstų rengyklėje ar užrašų programėlėje ir įklijuoti bet kur. Rezultatų puslapyje jį galite atsisiųsti; garso įrašas ir nuorašas vėliau automatiškai ištrinami.
Kalbos atpažinimo kokybė priklauso nuo garso kokybės. Didžiausią įtaką daro trys dalykai: atstumas, triukšmas ir persidengiantis kalbėjimas. Mikrofoną laikykite 10–20 cm atstumu nuo burnos – arti laikomas telefonas bus geresnis nei kitoje stalo pusėje esantis nešiojamasis kompiuteris. Išjunkite ventiliatorius, uždarykite langą ir venkite patalpų su stipriu aidu.
Kalbėkite įprastu tempu ir užbaikite sakinius – modelis naudoja kontekstą, todėl nebaigti sakiniai ir užpildantys žodžiai lemia prastesnį tekstą nei šiek tiek lėtesnė, bet aiški ir baigta kalba. Interviu metu paprašykite žmonių nekalbėti vieniems per kitus; persidengiantį kalbėjimą sunkiausia atpažinti bet kuriai kalbos atpažinimo sistemai.
Prieš pradėdami paklausykite peržiūros. Jei lygio matuoklis vos juda arba nuolat rodo maksimalų lygį, įrašykite dar kartą, užuot tikėjęsi, kad transkripcija bus tiksli.
Šį įrankį naudoja mokytojai, tinklalaidžių kūrėjai, žurnalistai ir visi, kuriems lengviau išdėstyti mintis balsu nei rašant klaviatūra: rengiant el. laiško ar straipsnio juodraštį kalbant, užrašant susitikimo protokolą, paskaitą ar balso įrašą paverčiant užrašuose, kuriuose galima ieškoti, perrašant interviu atsakymus tyrimams ir gaunant įskaitomą balso žinutės, kurios šiuo metu negalima perklausyti, versiją.
Kadangi Whisper kalbą nustato automatiškai, tas pats puslapis veikia su vokišku diktavimu, ispanišku balso įrašu ar angliška paskaita be jokių nustatymų. Transkriptas nėra verčiamas – jis užrašomas ta kalba, kuria buvo kalbėta.
Garso įrašams, kurie jau yra faile – tinklalaidėms, paskaitoms, skambučiams – šios svetainės garso į tekstą ir MP3 į tekstą keitikliai naudoja tą pačią sistemą su tomis pačiomis parinktimis.
Ji neverčia: nuorašai pateikiami šnekamąja kalba. Ji nesukuria subtitrų laiko žymų – SRT ar VTT failams naudokite šioje svetainėje esančius subtitrų konverterius. Ji neatpažįsta kalbėtojų pagal vardą, tik pagal kalbėtojo pasikeitimą, kai įjungtas kalbėtojų aptikimas. Be to, ji negali atkurti įraše negirdimų žodžių.
Tikriniai vardai, produktų pavadinimai ir reti trumpiniai yra dažniausios klaidos; švariam įrašui paprastai pakanka greitai peržiūrėti rezultatą, atkreipiant į juos dėmesį.