隱私優先
上傳的檔案會在兩小時內自動永久刪除。
自動刪除

由工程師開發,具備10 年以上經驗,專精於大型基礎架構、 資料系統與科學運算。專為重視隱私、 可靠處理與實用性的真實音訊工作流程而設計。
上傳的檔案會在兩小時內自動永久刪除。
在 Trustpilot 上因速度、穩定性與易用性獲得 5 星 評分。
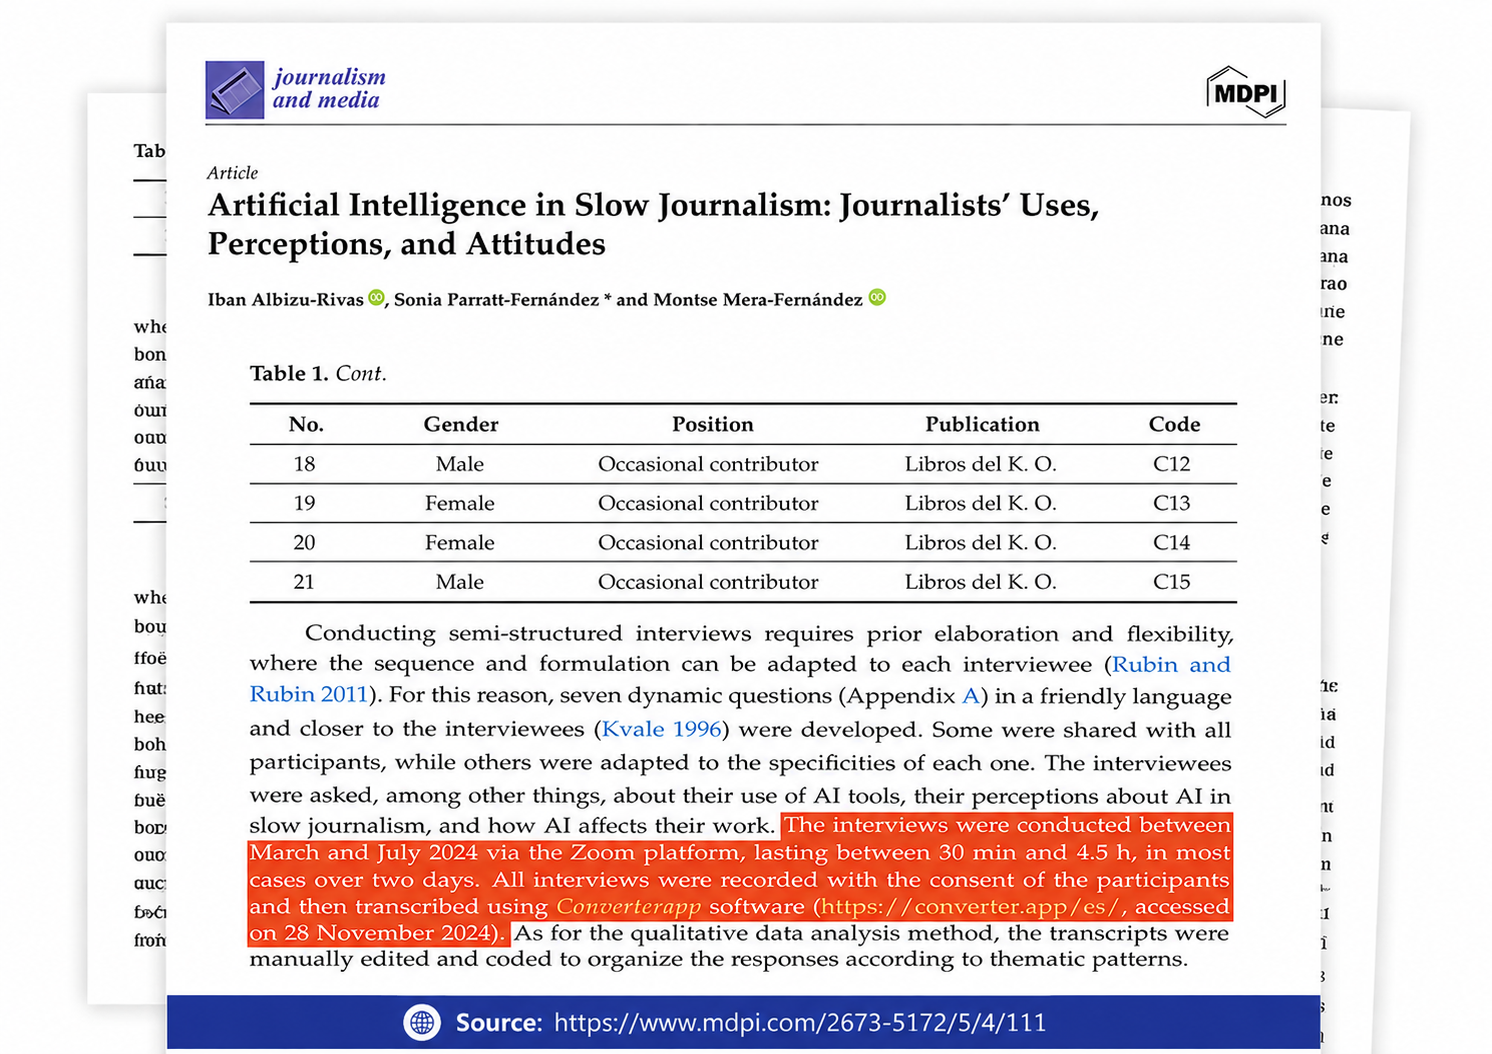
已發表於研究文獻中,並用於訪談逐字稿整理與質性資料分析。
您的瀏覽器會將麥克風錄音儲存為 Opus 音訊(Chrome、Firefox、Edge)或 AAC(Safari),並保留在記憶體中。當您確認後,檔案會透過 HTTPS 上傳至我們其中一台語音轉文字伺服器。
在伺服器上,ffmpeg 會解碼音訊,而 Whisper 這個開放原始碼語音辨識模型會一次將音訊轉換為文字,包括標點符號與句子分段。若啟用說話者偵測,系統會先透過說話者分離模型依不同說話者劃分音訊,並在逐字稿中加入相應標註。
逐字稿會儲存為使用一般標點符號與段落分行的純 UTF 8 文字檔,因此可在任何文字編輯器、文書處理軟體或筆記 App 中開啟,也能貼到任何地方。您可在結果頁面下載檔案;之後音訊與逐字稿都會自動刪除。
語音辨識的效果取決於音訊品質。影響最大的三個因素是距離、雜訊和重疊說話。請讓麥克風與嘴巴保持 10–20 公分的距離;近距離拿著手機錄音,效果通常比放在桌子另一端的筆電更好。請關閉風扇、關上窗戶,並避免在回音明顯的房間錄音。
請以正常速度說話並說完整句子——模型會利用上下文,因此說到一半的句子和填充詞,產生的文字會比稍微放慢速度、完整說話的效果更差。訪談時,請提醒大家不要同時說話;重疊語音是任何辨識系統最難處理的情況。
開始前請先聆聽預覽。如果音量計幾乎沒有動,或一直顯示在最高位置,建議重新錄製,不要期待轉錄文字能正確產生。
此工具適合教師、Podcaster、記者,以及任何用說話比用鍵盤打字更快的人:透過說話草擬電子郵件或文章、記錄會議紀錄、將講座或語音備忘錄轉成可搜尋的筆記、為研究用途轉錄訪談回答,或取得目前無法播放的語音訊息之可閱讀文字版本。
由於 Whisper 會自動偵測語言,同一個頁面無需任何設定,即可處理德語聽寫、西班牙語語音筆記或英語講座。轉錄文字不會被翻譯,而是會以實際說出的語言呈現。
對於已經儲存為檔案的音訊,例如 Podcast、講座或通話錄音,本網站的音訊轉文字與 MP3 轉文字工具會使用相同的智慧引擎及相同選項。
此工具不會翻譯:轉錄文字會保留為語音原本的語言。它不會產生字幕時間碼,如需建立 SRT 或 VTT 檔案,請使用本網站的字幕轉換工具。啟用說話者偵測時,它只會偵測說話者變更,不會依姓名辨識說話者。它也無法還原錄音中聽不清楚的詞語。
專有名詞、產品名稱和罕見縮寫最容易出現錯誤;只要在查看結果時特別留意這些內容,通常就是清晰錄音所需的全部編輯工作。