Privātums pirmajā vietā
Augšupielādētie faili tiek automātiski un neatgriezeniski dzēsti divu stundu laikā.
Automātiska dzēšana

Izstrādājuši inženieri ar vairāk nekā 10 gadu pieredzi lielapjoma infrastruktūrā, datu sistēmās un zinātniskajā skaitļošanā. Radīts reālām audio darba plūsmām, kur svarīga ir privātums, uzticama apstrāde un praktiska lietojamība.
Augšupielādētie faili tiek automātiski un neatgriezeniski dzēsti divu stundu laikā.
Novērtēts ar 5 zvaigznēm vietnē Trustpilot par ātrumu, uzticamību un lietošanas ērtumu.
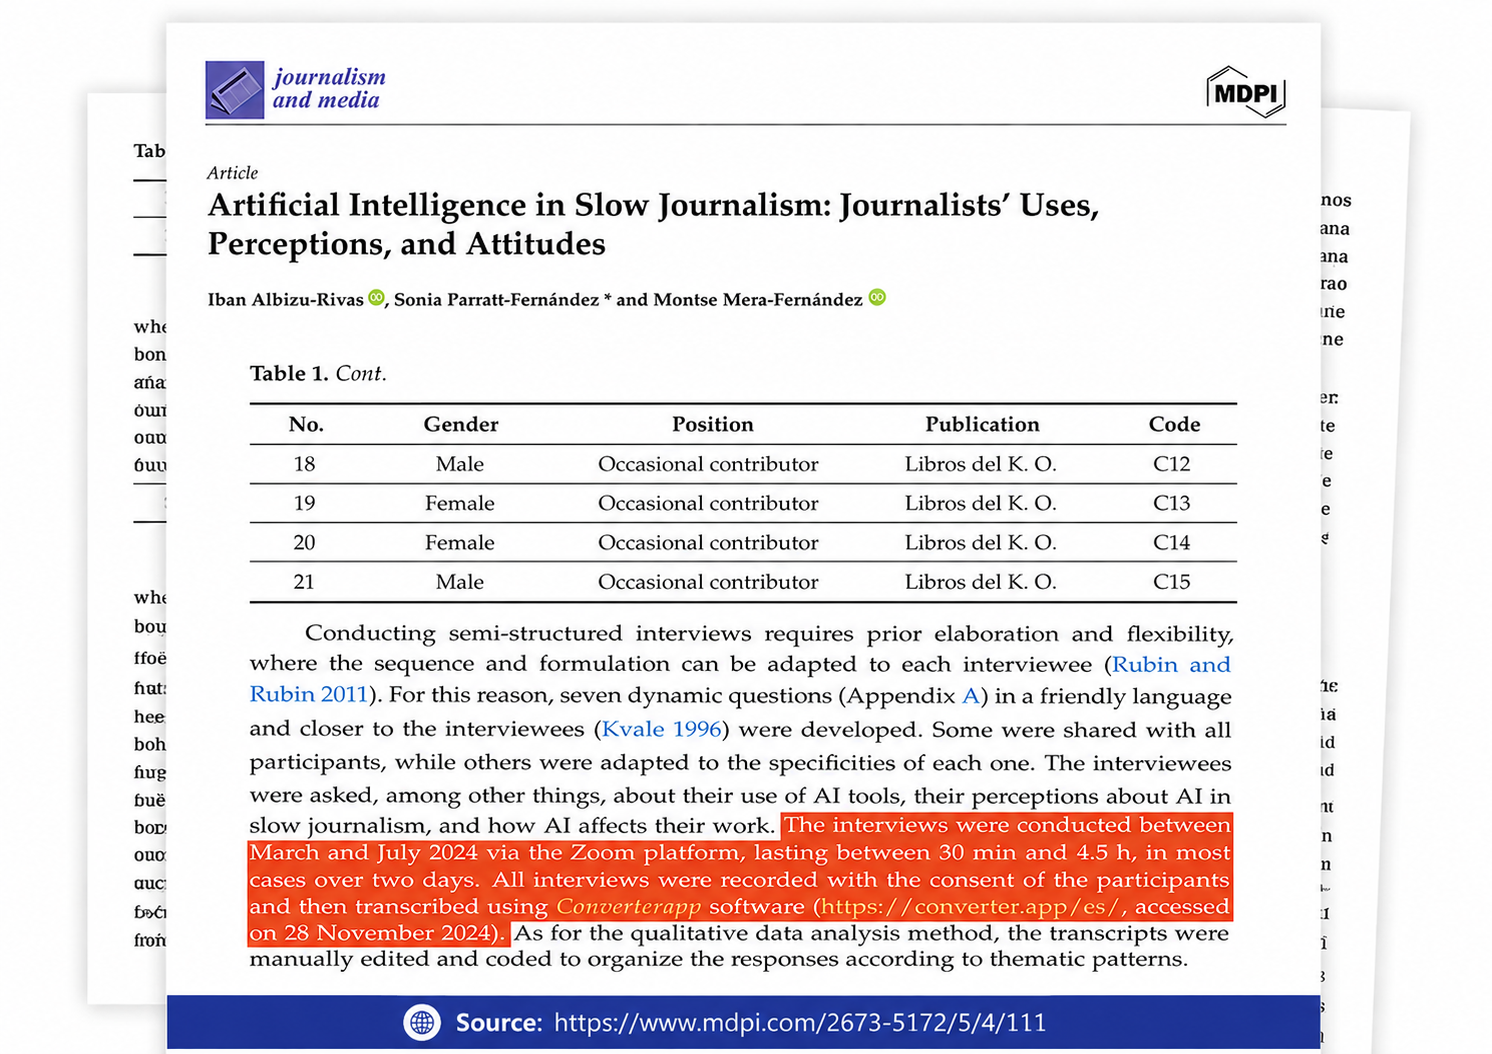
Minēts publicētā pētījumā un izmantots interviju transkripcijai un kvalitatīvu datu analīzei.
Jūsu pārlūkprogramma ieraksta mikrofonu kā Opus audio (Chrome, Firefox, Edge) vai AAC (Safari) un saglabā to atmiņā. Kad apstiprināt, fails tiek augšupielādēts, izmantojot HTTPS, vienā no mūsu transkribēšanas serveriem.
Tur ffmpeg atkodē audio, un Whisper – atvērtā pirmkoda runas atpazīšanas modelis – vienā reizē pārvērš to tekstā, iekļaujot pieturzīmes un teikumu pārtraukumus. Ja ir ieslēgta runātāju noteikšana, diarizācijas modelis vispirms sadala audio pa runātājiem, un transkripts tiek attiecīgi anotēts.
Transkripts tiek saglabāts kā vienkāršs UTF 8 teksta fails ar parastām pieturzīmēm un rindkopu pārtraukumiem, tāpēc to var atvērt jebkurā redaktorā, tekstapstrādes programmā vai piezīmju lietotnē un ielīmēt jebkur. Rezultātu lapā to var lejupielādēt; audio un transkripts pēc tam tiek automātiski dzēsti.
Runas atpazīšanas kvalitāte ir atkarīga no audio ieraksta kvalitātes. Vislielāko atšķirību rada trīs faktori: attālums, troksnis un pārklāšanās. Turiet mikrofonu 10–20 cm attālumā no mutes; tuvu turēts tālrunis ir labāks par klēpjdatoru galda otrā pusē. Izslēdziet ventilatorus, aizveriet logu un izvairieties no telpām ar spēcīgu atbalsi.
Runājiet normālā tempā un pabeidziet teikumus — modelis izmanto kontekstu, tāpēc nepabeigti teikumi un parazītvārdi rada sliktāku tekstu nekā nedaudz lēnāka, pilnīga runa. Intervijās lūdziet cilvēkus nerunāt vienlaikus; pārklājoša runa ir vissarežģītākais gadījums jebkurai runas atpazīšanas sistēmai.
Pirms sākšanas noklausieties priekšskatījumu. Ja līmeņa mērītājs tikko kustas vai pastāvīgi rāda maksimālo līmeni, ierakstiet audio no jauna, nevis ceriet, ka transkripcija izdosies pareiza.
Šo rīku izmanto skolotāji, podkāstu veidotāji, žurnālisti un ikviens, kurš runājot domā ātrāk nekā rakstot ar tastatūru: e-pasta vai raksta melnraksta veidošanai runājot, sapulču protokolēšanai, lekcijas vai balss piezīmes pārvēršanai meklējamās piezīmēs, interviju atbilžu transkribēšanai pētījumiem un lasāmas balss ziņas versijas iegūšanai, ja to pašlaik nevar atskaņot.
Tā kā Whisper valodu nosaka automātiski, šī pati lapa bez papildu iestatījumiem darbojas vācu diktātam, spāņu balss piezīmei vai angļu lekcijai. Transkripcija netiek tulkota — tā tiek izveidota runātajā valodā.
Audio failiem, kas jau pastāv kā faili — podkāstiem, lekcijām, zvaniem — šīs vietnes audio-uz-tekstu un MP3 uz tekstu konvertētāji izmanto to pašu sistēmu ar tām pašām iespējām.
Tas netulko: transkripti ir runātajā valodā. Tas neveido subtitru laika atzīmes — SRT vai VTT failiem izmantojiet šīs vietnes subtitru konvertētājus. Tas neidentificē runātājus pēc vārda, tikai nosaka runātāja maiņu, ja ir ieslēgta runātāju noteikšana. Tas arī nevar atjaunot vārdus, kas ierakstā nav dzirdami.
Īpašvārdi, produktu nosaukumi un reti saīsinājumi ir visbiežāk sastopamās kļūdas; tīram ierakstam parasti pietiek ar ātru rezultāta pārskatīšanu, pievēršot tiem uzmanību.