隱私優先
上傳的檔案會在兩小時內自動永久刪除。
自動刪除

由工程師開發,具備10 年以上經驗,專精於大型基礎架構、 資料系統與科學運算。專為重視隱私、 可靠處理與實用性的真實音訊工作流程而設計。
上傳的檔案會在兩小時內自動永久刪除。
在 Trustpilot 上因速度、穩定性與易用性獲得 5 星 評分。
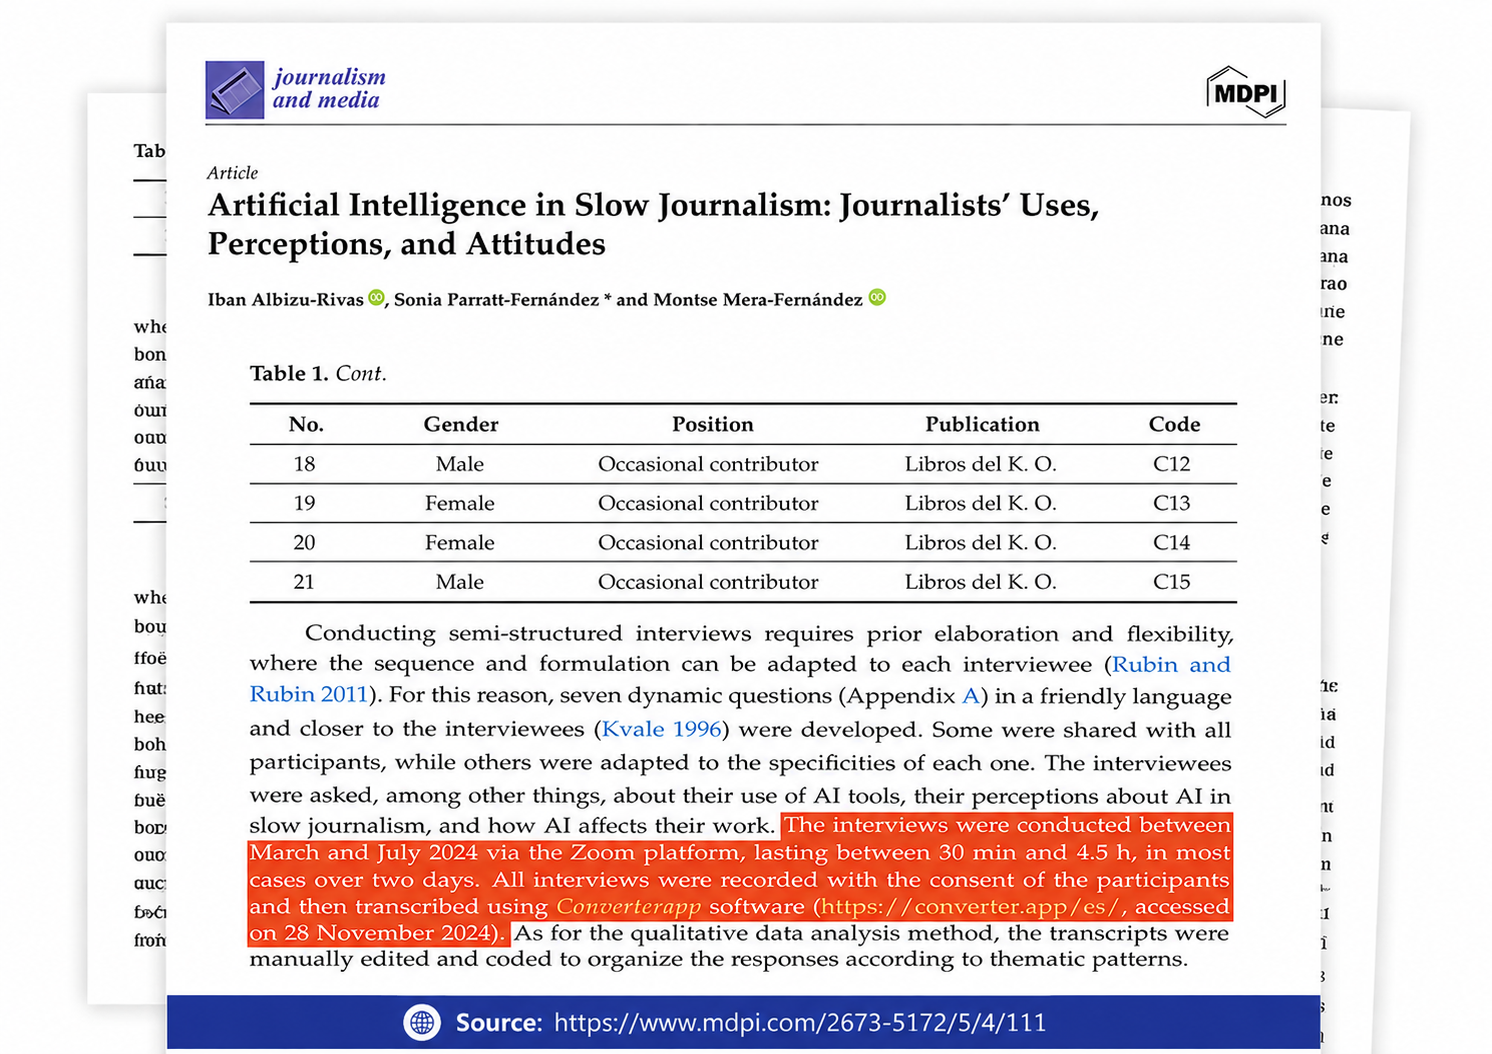
已發表於研究文獻中,並用於訪談逐字稿整理與質性資料分析。
您的瀏覽器會將麥克風錄音儲存為 Opus 音訊(Chrome、Firefox、Edge)或 AAC(Safari),並保留在記憶體中。當您確認後,檔案會透過 HTTPS 上傳至我們其中一台語音轉文字伺服器。
在伺服器上,ffmpeg 會解碼音訊,而 Whisper——一個開源語音辨識模型——會一次將其轉換為文字,包括標點符號與句子分段。若啟用說話者偵測,系統會先透過說話者分離模型依說話者拆分音訊,並據此為逐字稿加上標註。
逐字稿會儲存為使用一般標點符號與段落分隔的純 UTF 8 文字檔,因此可在任何文字編輯器、文書處理軟體或筆記 App 中開啟,也能貼到任何地方。您可在結果頁面下載檔案;之後音訊與逐字稿會自動刪除。
語音辨識的效果取決於音訊品質。影響最大的三個因素是距離、雜訊與語音重疊。請將麥克風保持在距離嘴巴 10–20 公分處;靠近嘴巴拿著手機,比起放在桌子另一端的筆電效果更好。請關閉風扇、關上窗戶,並避免在回音嚴重的房間錄音。
請以正常速度說話,並說完整句子——模型會利用上下文,因此半句話和贅詞產生的文字效果會比稍微放慢速度、完整說話更差。進行訪談時,請提醒大家不要同時說話;語音重疊是所有辨識系統最難處理的情況。
開始前請先聆聽預覽。如果音量表幾乎沒有動作,或持續顯示滿格,建議重新錄音,不要期待轉錄文字能正確產生。
這項工具適合教師、Podcast 製作者、記者,以及所有用說的比用鍵盤打字更快的人:透過說話撰寫電子郵件或文章、記錄會議紀要、將講座或語音備忘錄轉成可搜尋的筆記、為研究用途轉錄訪談回答,以及在暫時無法播放語音訊息時取得可閱讀的文字版本。
由於 Whisper 會自動偵測語言,同一個頁面無需任何設定即可用於德語聽寫、西班牙語語音筆記或英語講座。逐字稿不會被翻譯,而是會以原本說出的語言呈現。
對於已經存在的音訊檔案,例如 Podcast、講座和通話錄音,本網站的音訊轉文字和 MP3 轉文字工具會使用相同的引擎與選項。
此工具不會進行翻譯:轉錄文字會以語音所使用的語言呈現。它不會產生字幕時間軸;如需建立 SRT 或 VTT 檔案,請使用本網站的字幕轉換工具。它不會依姓名辨識說話者,只會在啟用說話者偵測時辨識說話者變更。此外,它無法還原錄音中聽不清楚的字詞。
專有名詞、產品名稱和罕見縮寫最容易出現錯誤;只要留意這些內容快速檢查結果,通常就是清晰錄音所需的全部編輯工作。