ความเป็นส่วนตัวมาก่อน
ไฟล์ที่อัปโหลดจะถูกลบโดยอัตโนมัติและถาวรภายในสองชั่วโมง
การลบอัตโนมัติ

พูดตามคำบอก การบรรยาย โน้ตจากการบรรยาย คำตอบจากการสัมภาษณ์ หรือเสียงพากย์สั้น ๆ ลงในเบราว์เซอร์โดยตรง หรืออัปโหลดไฟล์บันทึกเสียง แล้วรับข้อความเป็นไฟล์ข้อความธรรมดา (.txt, UTF 8) ระบบถอดเสียงทำงานด้วย Whisper โมเดลรู้จำเสียงแบบโอเพนซอร์ส บนเซิร์ฟเวอร์ของเราเอง รองรับประมาณ 100 ภาษาและตรวจจับภาษาโดยอัตโนมัติ
หน้านี้รวมเครื่องมือบันทึกเสียงในเบราว์เซอร์เข้ากับระบบถอดเสียงด้วย GPU การบันทึกใช้อินเทอร์เฟซ MediaRecorder ที่มีอยู่ใน Chrome, Firefox, Edge และ Safari ส่วนการรู้จำเสียงดำเนินการโดย Whisper โมเดลโอเพนซอร์สที่เผยแพร่โดย OpenAI ซึ่งทำงานบนฮาร์ดแวร์ของเราเองแทนการใช้ API ของบุคคลที่สาม
กด "บันทึกด้วยไมโครโฟนของคุณ" อนุญาตการเข้าถึงหนึ่งครั้ง แล้วเริ่มพูด ตัวจับเวลาและมาตรวัดระดับเสียงจะแสดงให้ทราบว่ากำลังรับเสียงอยู่ หรืออัปโหลดไฟล์บันทึกเสียงที่มีอยู่แล้วก็ได้ เช่น บันทึกเสียงจากโทรศัพท์ทุกรุ่น
ฟังไฟล์เสียงในกล่องโต้ตอบ เปิดใช้ "ตรวจจับผู้พูดหลายคน" สำหรับการสัมภาษณ์และการประชุม (ระบบจะระบุว่าใครกำลังพูด แต่ใช้เวลานานขึ้นอย่างเห็นได้ชัด) จากนั้นเริ่มถอดเสียงเป็นข้อความ
แสดงความคืบหน้าขณะที่โมเดลทำงาน โดยเสียงพูดความยาวไม่กี่นาทีมักใช้เวลาไม่ถึงหนึ่งนาที ดาวน์โหลดไฟล์ข้อความล้วน (.txt, UTF 8) ได้จากหน้าผลลัพธ์
Whisper ได้รับการฝึกฝนด้วยเสียงหลายภาษากว่า 680,000 ชั่วโมง จึงรองรับสำเนียง เสียงรบกวนรอบข้าง และคำศัพท์เฉพาะทางได้ดีกว่าระบบถอดเสียงเมื่อไม่กี่ปีก่อนมาก ระบบจะตรวจจับภาษาโดยอัตโนมัติ
สำหรับการสนทนา การตรวจจับผู้พูดเสริมจะระบุการเปลี่ยนผู้พูดในข้อความถอดเสียง โดยจะใช้เวลาประมวลผลเพิ่มขึ้นประมาณสองเท่า จึงปิดไว้เป็นค่าเริ่มต้น
ไฟล์ถอดเสียงจะถูกบันทึกเป็นไฟล์ข้อความ UTF 8 แบบธรรมดา พร้อมเครื่องหมายวรรคตอนและการขึ้นย่อหน้าตามปกติ จึงสามารถเปิดได้ในโปรแกรมแก้ไขข้อความ โปรแกรมประมวลผลคำ หรือแอปจดบันทึกทุกประเภท และสามารถวางได้ทุกที่
ไม่ต้องมีบัญชี ไม่มีลายน้ำ ไม่มีตัวนับช่วงทดลองใช้ ไฟล์บันทึกเสียงจะไม่ออกจากอุปกรณ์ของคุณจนกว่าคุณจะยืนยัน และไฟล์เสียงกับข้อความถอดเสียงจะถูกลบโดยอัตโนมัติหลังประมวลผลเสร็จสิ้น
พัฒนาโดยวิศวกรที่มีประสบการณ์มากกว่า 10 ปี ในโครงสร้างพื้นฐานขนาดใหญ่, ระบบข้อมูล และการประมวลผลเชิงวิทยาศาสตร์ ออกแบบมาสำหรับเวิร์กโฟลว์เสียงในโลกจริงที่ความเป็นส่วนตัว การประมวลผลที่เชื่อถือได้ และการใช้งานที่เหมาะสมมีความสำคัญ.
ไฟล์ที่อัปโหลดจะถูกลบโดยอัตโนมัติและถาวรภายในสองชั่วโมง
ได้รับคะแนน 5 ดาว บน Trustpilot ในด้านความเร็ว ความน่าเชื่อถือ และความง่ายในการใช้งาน
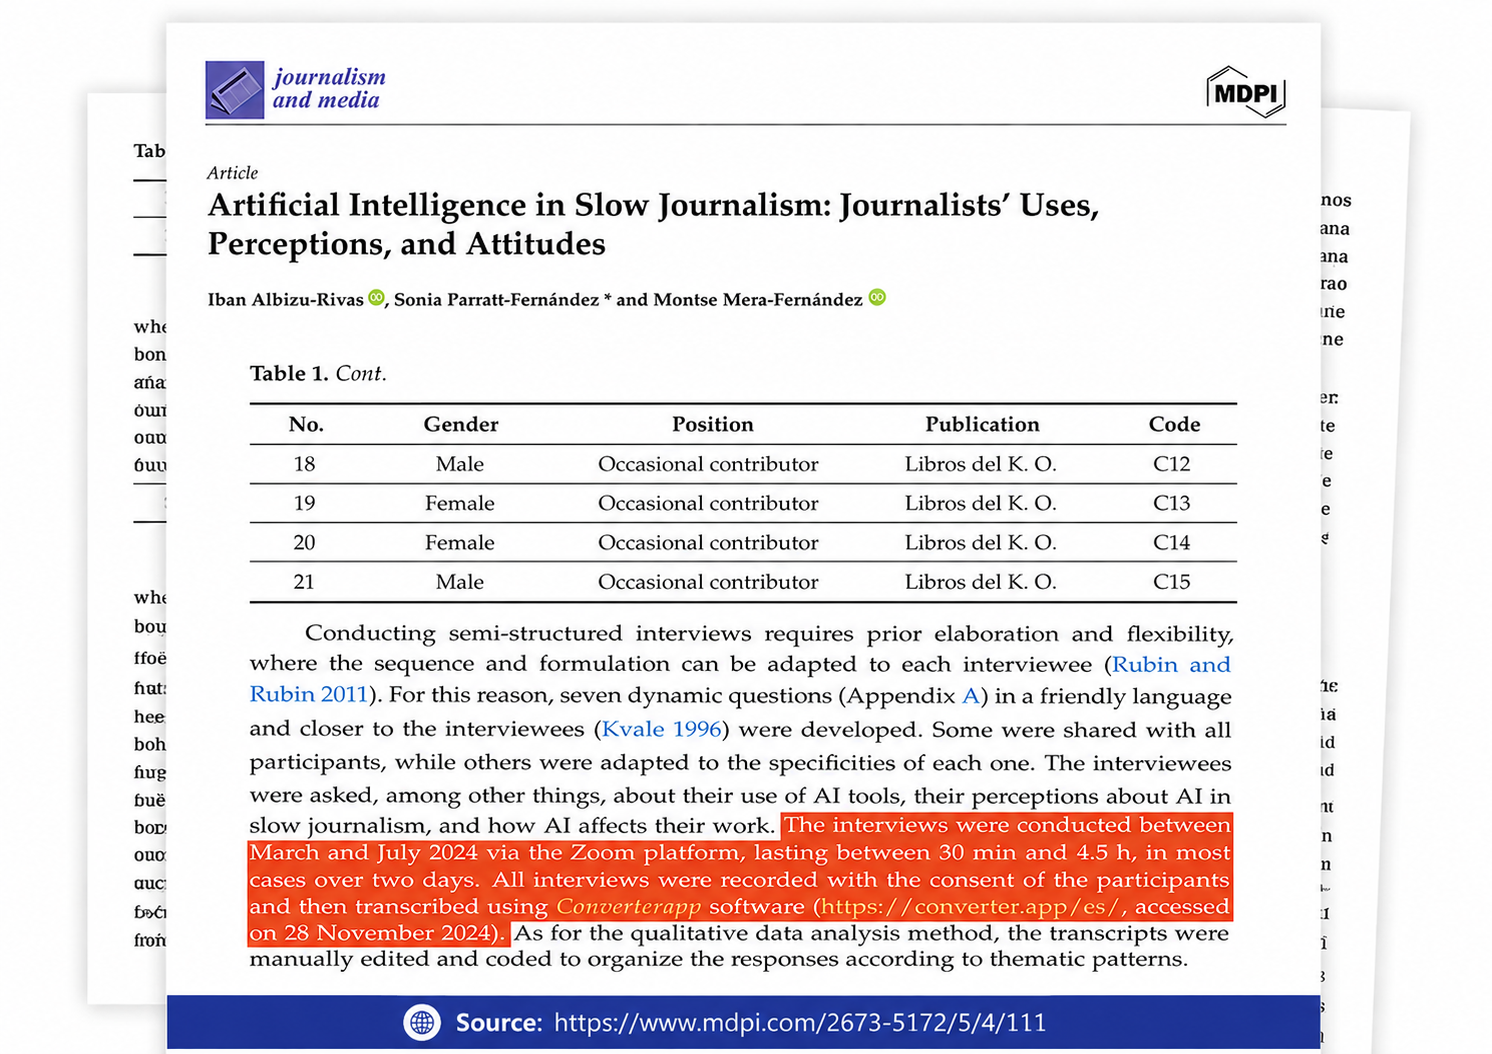
อ้างอิงในงานวิจัยที่เผยแพร่ และใช้สำหรับการถอดความบทสัมภาษณ์และการวิเคราะห์ข้อมูลเชิงคุณภาพ
เบราว์เซอร์ของคุณจะบันทึกเสียงจากไมโครโฟนเป็นเสียง Opus (Chrome, Firefox, Edge) หรือ AAC (Safari) และเก็บไว้ในหน่วยความจำ เมื่อคุณยืนยัน ไฟล์จะถูกอัปโหลดผ่าน HTTPS ไปยังหนึ่งในเซิร์ฟเวอร์ถอดเสียงของเรา
จากนั้น ffmpeg จะถอดรหัสเสียง และ Whisper – โมเดลรู้จำเสียงพูดแบบโอเพนซอร์ส – จะแปลงเป็นข้อความในขั้นตอนเดียว พร้อมเครื่องหมายวรรคตอนและการขึ้นประโยคใหม่ หากเปิดใช้การตรวจจับผู้พูด โมเดลแยกผู้พูดจะแบ่งเสียงตามผู้พูดก่อน แล้วจึงใส่คำอธิบายกำกับลงในข้อความถอดเสียงตามนั้น
ข้อความถอดเสียงจะถูกบันทึกเป็นไฟล์ข้อความ UTF 8 แบบธรรมดาที่มีเครื่องหมายวรรคตอนและการขึ้นย่อหน้าตามปกติ จึงเปิดได้ในโปรแกรมแก้ไขข้อความ โปรแกรมประมวลผลคำ หรือแอปจดบันทึกทุกประเภท และสามารถวางได้ทุกที่ หน้าผลลัพธ์ให้คุณดาวน์โหลดไฟล์ได้ จากนั้นไฟล์เสียงและข้อความถอดเสียงจะถูกลบโดยอัตโนมัติ
การรู้จำเสียงพูดจะมีประสิทธิภาพได้ดีเพียงใดขึ้นอยู่กับคุณภาพเสียงเป็นหลัก โดยมี 3 ปัจจัยที่ส่งผลมากที่สุด ได้แก่ ระยะห่าง เสียงรบกวน และการพูดทับกัน ควรวางไมโครโฟนให้ห่างจากปาก 10–20 ซม. การถือโทรศัพท์ไว้ใกล้ปากให้ผลดีกว่าใช้แล็ปท็อปที่วางอยู่อีกฝั่งของโต๊ะ ปิดพัดลม ปิดหน้าต่าง และหลีกเลี่ยงห้องที่มีเสียงก้องมาก
พูดด้วยความเร็วตามปกติและพูดให้จบประโยค ระบบจะใช้บริบทในการประมวลผล ดังนั้นการพูดไม่จบประโยคและคำอุทานแทรกจะทำให้ข้อความที่ได้แย่กว่าการพูดช้าลงเล็กน้อยแต่พูดได้ครบถ้วน สำหรับการสัมภาษณ์ ควรขอให้ผู้พูดไม่พูดทับกัน เนื่องจากเสียงพูดที่ซ้อนทับกันเป็นกรณีที่ระบบรู้จำเสียงพูดทุกประเภทจัดการได้ยากที่สุด
ฟังตัวอย่างเสียงก่อนเริ่มต้น หากตัววัดระดับเสียงแทบไม่ขยับหรืออยู่ที่ระดับสูงสุดตลอดเวลา ควรบันทึกเสียงใหม่แทนที่จะหวังว่าข้อความถอดเสียงจะออกมาถูกต้อง
เครื่องมือนี้เหมาะสำหรับครู พอดแคสเตอร์ นักข่าว และทุกคนที่คิดได้เร็วกว่าเมื่อพูดออกมามากกว่าพิมพ์บนแป้นพิมพ์: ร่างอีเมลหรือบทความด้วยการพูด บันทึกรายงานการประชุม เปลี่ยนการบรรยายหรือบันทึกเสียงให้เป็นโน้ตที่ค้นหาได้ ถอดคำตอบจากการสัมภาษณ์เพื่อใช้ในการวิจัย และรับข้อความที่อ่านได้จากข้อความเสียงที่ไม่สามารถเล่นได้ในขณะนี้
เนื่องจาก Whisper ตรวจจับภาษาโดยอัตโนมัติ หน้าเดียวกันนี้จึงใช้ได้กับการเขียนตามคำบอกภาษาเยอรมัน บันทึกเสียงภาษาสเปน หรือการบรรยายภาษาอังกฤษโดยไม่ต้องตั้งค่าใดๆ ข้อความถอดเสียงจะไม่ถูกแปล แต่จะเขียนด้วยภาษาที่พูด
สำหรับเสียงที่มีอยู่แล้วเป็นไฟล์ เช่น พอดแคสต์ การบรรยาย หรือการโทร ตัวแปลงเสียงเป็นข้อความและ MP3 เป็นข้อความบนเว็บไซต์นี้ใช้ระบบเดียวกันพร้อมตัวเลือกเดียวกัน
ระบบนี้ไม่แปลภาษา: ข้อความถอดเสียงจะเป็นภาษาที่พูดในไฟล์เสียง ระบบจะไม่สร้างช่วงเวลาของคำบรรยาย – หากต้องการไฟล์ SRT หรือ VTT ให้ใช้เครื่องมือแปลงคำบรรยายบนเว็บไซต์นี้ ระบบจะไม่ระบุชื่อผู้พูด แต่จะแสดงเฉพาะการเปลี่ยนผู้พูดเมื่อเปิดใช้การตรวจจับผู้พูด และไม่สามารถกู้คืนคำที่ฟังไม่ชัดในไฟล์บันทึกได้
ชื่อเฉพาะ ชื่อผลิตภัณฑ์ และตัวย่อที่พบได้น้อยเป็นข้อผิดพลาดที่พบบ่อยที่สุด โดยทั่วไปเพียงตรวจทานผลลัพธ์อย่างรวดเร็วโดยคำนึงถึงสิ่งเหล่านี้ ก็เพียงพอสำหรับการแก้ไขไฟล์บันทึกที่มีเสียงชัดเจน
เมื่อไฟล์บันทึกเสียงมีความชัดเจนและมีผู้พูดเพียงคนเดียว Whisper มักถอดคำได้ถูกต้องมากกว่า 90% สำหรับภาษาหลัก ๆ รวมถึงการใส่เครื่องหมายวรรคตอน ความแม่นยำจะลดลงเมื่อมีเสียงรบกวนพื้นหลังมาก มีหลายคนพูดทับกัน เสียงเบามาก หรือมีสำเนียงท้องถิ่นเข้มข้น โดยเคล็ดลับการบันทึกเสียงด้านล่างช่วยได้มากกว่าการตั้งค่าใด ๆ
Whisper รองรับประมาณ 100 ภาษา และตรวจจับภาษาโดยอัตโนมัติจากช่วงไม่กี่วินาทีแรกของเสียง จึงไม่ต้องตั้งค่าใดๆ การบันทึกเสียงที่มีหลายภาษาจะถูกถอดเสียงเป็นภาษาหลัก ข้อความถอดเสียงจะเขียนเป็นภาษาที่พูด และจะไม่มีการแปล
ไม่ เครื่องบันทึกจะเก็บเสียงไว้ในเบราว์เซอร์ของคุณจนกว่าคุณจะกดปุ่มในกล่องโต้ตอบ หากคุณยกเลิกหรือปิดแท็บ จะไม่มีการส่งข้อมูลใด ๆ ไฟล์ที่อัปโหลดและข้อความถอดเสียงจะถูกลบโดยอัตโนมัติหลังจากประมวลผลเสร็จสิ้น
เครื่องบันทึกเสียงในเบราว์เซอร์จะหยุดหลังจาก 30 นาที ส่วนไฟล์ที่อัปโหลดสามารถมีความยาวได้นานกว่านั้น เวลาในการประมวลผลจะเพิ่มขึ้นตามความยาวของไฟล์เสียง และการตรวจจับผู้พูดจะใช้เวลาเพิ่มขึ้นอีกประมาณเท่ากัน
ระบบจะดำเนินการแยกผู้พูดก่อนถอดเสียง และแทรกตัวบ่งชี้ทุกครั้งที่ผู้พูดเปลี่ยนไป ใช้สำหรับบทสัมภาษณ์ การประชุม และพอดแคสต์; ปิดไว้สำหรับการเขียนตามคำบอกและบันทึกเสียง เพราะจะเพิ่มเวลาในการรอเท่านั้น
ใช่ – ผลลัพธ์จะเป็นไฟล์ .txt แบบข้อความล้วน เปิดไฟล์ด้วยโปรแกรมแก้ไขข้อความใดก็ได้ แก้ไขชื่อหรือคำศัพท์เทคนิคที่โมเดลฟังผิด แล้ววางลงในตำแหน่งที่ต้องการ ชื่อเฉพาะและคำย่อที่พบไม่บ่อยมักเป็นสิ่งที่ควรตรวจสอบมากที่สุด