गोपनीयता पहले
अपलोड की गई फ़ाइलें दो घंटे के भीतर स्वचालित रूप से और स्थायी रूप से हटा दी जाती हैं।
स्वचालित हटाना

डिक्टेशन, वर्णन, व्याख्यान नोट्स, साक्षात्कार के उत्तर या त्वरित वॉइस-ओवर सीधे ब्राउज़र में बोलें, या कोई रिकॉर्डिंग अपलोड करें, और शब्दों को सादा टेक्स्ट फ़ाइल (.txt, UTF 8) के रूप में प्राप्त करें। ट्रांसक्रिप्शन हमारे अपने सर्वरों पर ओपन-सोर्स स्पीच रिकग्निशन मॉडल Whisper के माध्यम से होता है—लगभग 100 भाषाओं में, जिनका स्वतः पता लगाया जाता है।
यह पेज ब्राउज़र में चलने वाले रिकॉर्डर को GPU ट्रांसक्रिप्शन बैकएंड के साथ जोड़ता है। रिकॉर्डिंग के लिए Chrome, Firefox, Edge और Safari में मौजूद MediaRecorder इंटरफ़ेस का उपयोग किया जाता है; पहचान के लिए OpenAI द्वारा प्रकाशित ओपन-सोर्स मॉडल Whisper का उपयोग होता है, जो किसी तृतीय-पक्ष API के बजाय हमारे अपने हार्डवेयर पर चलता है।
"अपने माइक्रोफ़ोन से रिकॉर्ड करें" दबाएँ, एक बार एक्सेस की अनुमति दें और बोलें। टाइमर और लेवल मीटर पुष्टि करते हैं कि ऑडियो आ रहा है। या मौजूदा रिकॉर्डिंग अपलोड करें – किसी भी फ़ोन के वॉइस मेमो उपयुक्त हैं।
डायलॉग में रिकॉर्डिंग सुनें। इंटरव्यू और मीटिंग के लिए "एकाधिक वक्ताओं का पता लगाएँ" चालू करें (यह कौन बोल रहा है, इसे चिह्नित करता है, लेकिन इसमें काफ़ी अधिक समय लगता है)। फिर ट्रांसक्रिप्शन शुरू करें।
मॉडल के काम करने के दौरान प्रगति दिखाई जाती है; कुछ मिनट के भाषण को आमतौर पर एक मिनट से भी कम समय लगता है। परिणाम पेज से एक सादा टेक्स्ट फ़ाइल (.txt, UTF 8) डाउनलोड करें।
Whisper को 680,000 घंटे के बहुभाषी ऑडियो पर प्रशिक्षित किया गया है और यह कुछ वर्ष पहले के डिक्टेशन इंजनों की तुलना में उच्चारण, बैकग्राउंड शोर और तकनीकी शब्दावली को कहीं बेहतर ढंग से संभालता है। भाषा का पता स्वचालित रूप से लगाया जाता है।
बातचीत के लिए, वैकल्पिक स्पीकर पहचान ट्रांसक्रिप्ट में वक्ता के बदलावों को चिह्नित करती है। इससे प्रोसेसिंग समय लगभग दोगुना हो जाता है, इसलिए यह डिफ़ॉल्ट रूप से बंद रहती है।
ट्रांसक्रिप्ट को सामान्य विराम चिह्नों और पैराग्राफ़ ब्रेक के साथ एक साधारण UTF 8 टेक्स्ट फ़ाइल के रूप में सहेजा जाता है, इसलिए यह किसी भी एडिटर, वर्ड प्रोसेसर या नोट ऐप में खुल जाती है और कहीं भी पेस्ट की जा सकती है।
कोई खाता नहीं, कोई वॉटरमार्क नहीं, कोई ट्रायल काउंटर नहीं। पुष्टि करने तक रिकॉर्डिंग आपके डिवाइस से बाहर नहीं जाती, और प्रोसेसिंग के बाद ऑडियो व ट्रांसक्रिप्ट अपने-आप हटा दिए जाते हैं।
बड़े पैमाने के इन्फ्रास्ट्रक्चर, डेटा सिस्टम और वैज्ञानिक कंप्यूटिंग में 10+ वर्षों के अनुभव वाले इंजीनियरों द्वारा विकसित। वास्तविक-विश्व ऑडियो वर्कफ़्लो के लिए डिज़ाइन किया गया, जहाँ गोपनीयता, भरोसेमंद प्रोसेसिंग और व्यावहारिक उपयोगिता महत्वपूर्ण हैं।
अपलोड की गई फ़ाइलें दो घंटे के भीतर स्वचालित रूप से और स्थायी रूप से हटा दी जाती हैं।
गति, विश्वसनीयता और उपयोग में आसानी के लिए Trustpilot पर 5 स्टार रेटिंग प्राप्त।
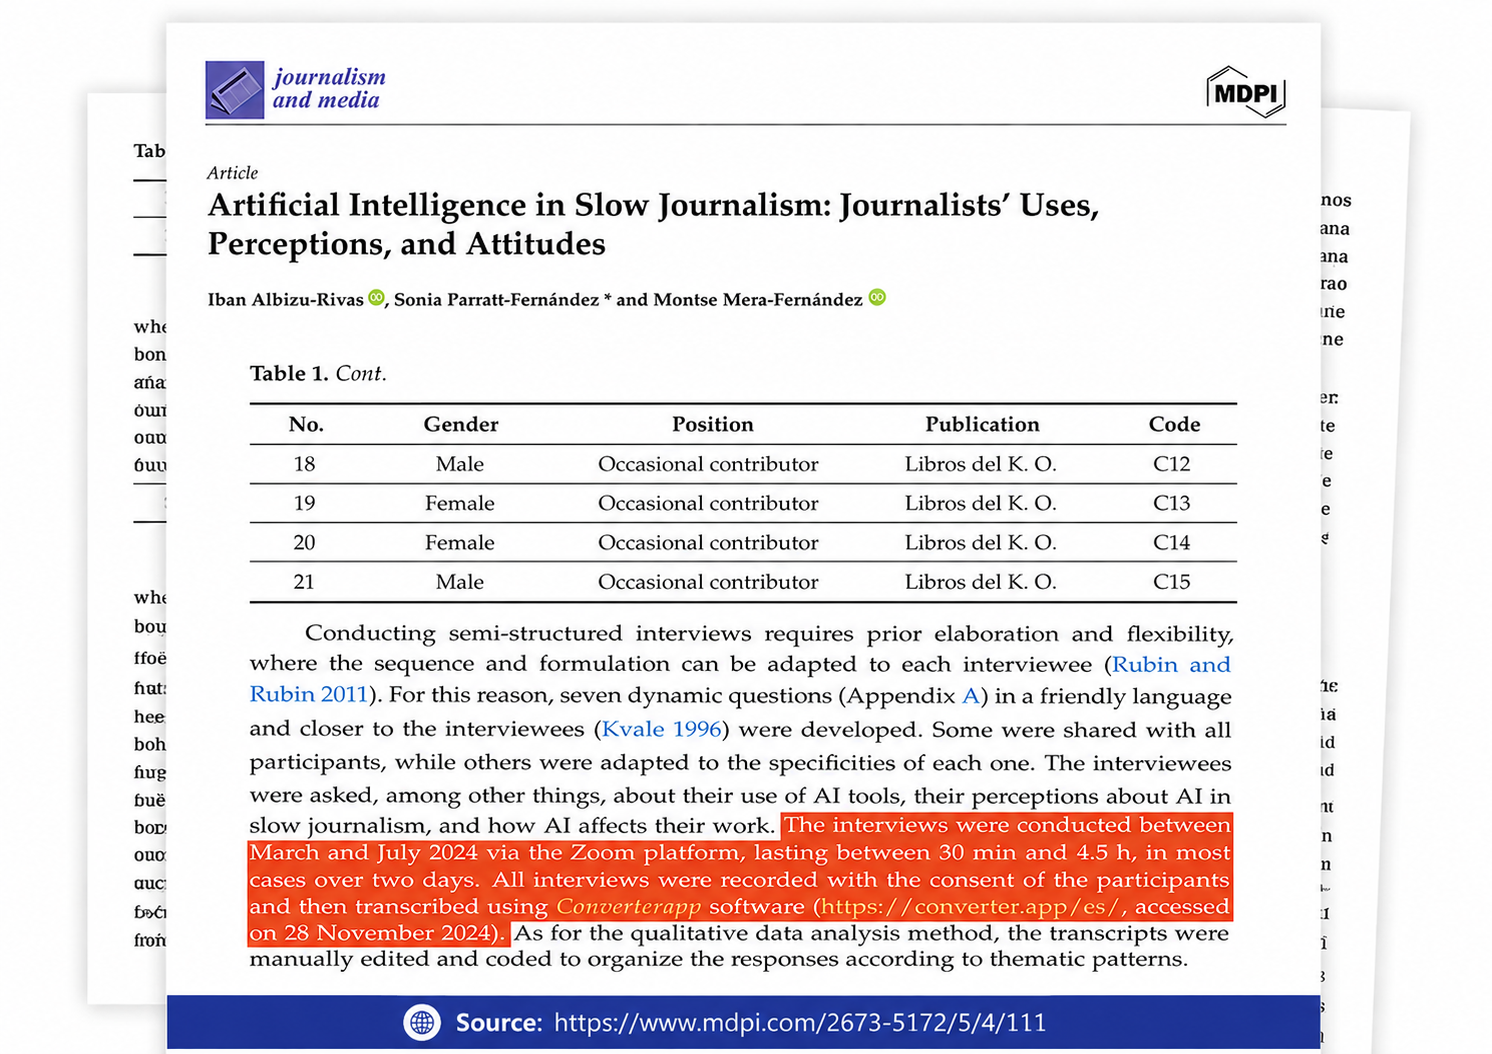
प्रकाशित शोध में संदर्भित और साक्षात्कार ट्रांसक्रिप्शन तथा गुणात्मक डेटा विश्लेषण के लिए उपयोग किया गया।
आपका ब्राउज़र माइक्रोफ़ोन की रिकॉर्डिंग को Opus ऑडियो (Chrome, Firefox, Edge) या AAC (Safari) के रूप में करता है और उसे मेमोरी में रखता है। आपकी पुष्टि करने पर, फ़ाइल HTTPS के माध्यम से हमारे किसी ट्रांसक्रिप्शन सर्वर पर अपलोड की जाती है।
वहाँ, ffmpeg ऑडियो को डिकोड करता है और Whisper – एक ओपन-सोर्स स्पीच रिकग्निशन मॉडल – विराम चिह्नों और वाक्य-विराम सहित उसे एक ही चरण में टेक्स्ट में बदल देता है। यदि स्पीकर डिटेक्शन चालू है, तो एक डायरीकरण मॉडल पहले ऑडियो को वक्ताओं के अनुसार विभाजित करता है और ट्रांसक्रिप्ट को उसी के अनुसार चिह्नित किया जाता है।
ट्रांसक्रिप्ट को सामान्य विराम चिह्नों और पैराग्राफ ब्रेक के साथ सादे UTF 8 टेक्स्ट फ़ाइल के रूप में सहेजा जाता है, इसलिए यह किसी भी एडिटर, वर्ड प्रोसेसर या नोट ऐप में खुल सकता है और इसे कहीं भी पेस्ट किया जा सकता है। परिणाम पृष्ठ से आप इसे डाउनलोड कर सकते हैं; इसके बाद ऑडियो और ट्रांसक्रिप्ट अपने आप हटा दिए जाते हैं।
वाक् पहचान की गुणवत्ता ऑडियो पर निर्भर करती है। तीन चीज़ें सबसे अधिक अंतर पैदा करती हैं: दूरी, शोर और एक साथ बोलना। माइक्रोफ़ोन को अपने मुंह से 10–20 cm की दूरी पर रखें; पास रखे फ़ोन से रिकॉर्डिंग करना, मेज़ के दूसरी ओर रखे लैपटॉप की तुलना में बेहतर है। पंखे बंद करें, खिड़की बंद करें और तेज़ गूंज वाले कमरों से बचें।
सामान्य गति से बोलें और वाक्य पूरे करें – मॉडल संदर्भ का उपयोग करता है, इसलिए अधूरे वाक्य और अनावश्यक शब्द, थोड़ा धीमे लेकिन पूरे बोलने की तुलना में खराब टेक्स्ट देते हैं। इंटरव्यू के लिए लोगों से एक-दूसरे के ऊपर बोलने से बचने को कहें; एक साथ बोलना किसी भी वाक् पहचान प्रणाली के लिए सबसे कठिन स्थिति है।
शुरू करने से पहले प्रीव्यू सुनें। यदि स्तर मीटर बहुत कम हिलता है या लगातार पूरी ऊंचाई पर रहता है, तो ट्रांसक्रिप्ट सही आने की उम्मीद करने के बजाय ऑडियो को फिर से रिकॉर्ड करें।
इस टूल का उपयोग शिक्षक, पॉडकास्टर, पत्रकार और वे सभी लोग करते हैं जो कीबोर्ड पर टाइप करने की तुलना में बोलकर अधिक तेज़ी से सोचते हैं: बोलकर ई-मेल या लेख का मसौदा तैयार करना, मीटिंग के मिनट्स रिकॉर्ड करना, किसी व्याख्यान या वॉइस मेमो को खोजे जा सकने वाले नोट्स में बदलना, शोध के लिए साक्षात्कार के उत्तरों को ट्रांसक्राइब करना, और ऐसे वॉइस संदेश का पढ़ने योग्य संस्करण प्राप्त करना जिसे अभी चलाया नहीं जा सकता।
Whisper भाषा को अपने-आप पहचान लेता है, इसलिए यही पेज बिना किसी सेटिंग के जर्मन डिक्टेशन, स्पेनिश वॉइस नोट या अंग्रेज़ी व्याख्यान के लिए काम करता है। ट्रांसक्रिप्ट का अनुवाद नहीं किया जाता – इसे उसी भाषा में लिखा जाता है जिसमें बोला गया था।
जो ऑडियो पहले से फ़ाइल के रूप में मौजूद है – जैसे पॉडकास्ट, व्याख्यान या कॉल – उसके लिए इस साइट के ऑडियो-से-टेक्स्ट और MP3 से-टेक्स्ट कन्वर्टर समान विकल्पों के साथ उसी इंजन का उपयोग करते हैं।
यह अनुवाद नहीं करता: ट्रांसक्रिप्ट बोली गई भाषा में ही होते हैं। यह सबटाइटल टाइमिंग नहीं बनाता – SRT या VTT फ़ाइलों के लिए इस साइट के सबटाइटल कन्वर्टर का उपयोग करें। यह वक्ताओं की पहचान नाम से नहीं करता, केवल स्पीकर डिटेक्शन चालू होने पर वक्ता बदलने का पता लगाता है। और यह रिकॉर्डिंग में सुनाई न देने वाले शब्दों को पुनर्प्राप्त नहीं कर सकता।
व्यक्तियों के नाम, उत्पादों के नाम और दुर्लभ संक्षिप्ताक्षर सबसे आम त्रुटियाँ होते हैं; इन्हें ध्यान में रखकर परिणाम को एक बार जल्दी से पढ़ लेना आम तौर पर साफ़ रिकॉर्डिंग के लिए आवश्यक संपादन होता है।
स्पष्ट रिकॉर्डिंग और एक वक्ता होने पर, Whisper आमतौर पर प्रमुख भाषाओं में विराम-चिह्नों सहित 90% से अधिक शब्दों को सही पहचान लेता है। तेज़ बैकग्राउंड शोर, एक-दूसरे के ऊपर बोलते कई लोगों, बहुत धीमी आवाज़ या गहरी बोली के कारण सटीकता कम हो जाती है – नीचे दिए गए रिकॉर्डिंग सुझाव किसी भी सेटिंग से अधिक मदद करते हैं।
Whisper लगभग 100 भाषाओं को पहचानता है और ऑडियो के शुरुआती सेकंड से भाषा अपने आप चुन लेता है, इसलिए आपको कुछ भी सेट करने की आवश्यकता नहीं है। मिश्रित-भाषा वाली रिकॉर्डिंग का ट्रांसक्रिप्शन प्रमुख भाषा में किया जाता है। ट्रांसक्रिप्ट बोली गई भाषा में लिखा जाता है; इसका अनुवाद नहीं किया जाता।
नहीं। रिकॉर्डर ऑडियो को आपके ब्राउज़र में तब तक रखता है, जब तक आप डायलॉग में बटन नहीं दबाते। यदि आप रद्द करते हैं या टैब बंद कर देते हैं, तो कुछ भी भेजा नहीं जाता। अपलोड की गई फ़ाइलें और ट्रांसक्रिप्ट प्रोसेसिंग के बाद स्वचालित रूप से हटा दिए जाते हैं।
ब्राउज़र में रिकॉर्डर 30 मिनट के बाद रुक जाता है; अपलोड की गई फ़ाइलें इससे लंबी हो सकती हैं। प्रोसेसिंग समय ऑडियो की लंबाई के साथ बढ़ता है, और स्पीकर पहचान में लगभग उतना ही अतिरिक्त समय लगता है।
यह ट्रांसक्रिप्शन से पहले स्पीकर-डायराइज़ेशन चरण चलाता है और जब भी वक्ता बदलता है, एक मार्कर जोड़ता है। इसका उपयोग इंटरव्यू, मीटिंग और पॉडकास्ट के लिए करें; डिक्टेशन और वॉइस नोट्स के लिए इसे बंद रखें, क्योंकि वहाँ यह केवल प्रतीक्षा समय बढ़ाता है।
हाँ – परिणाम एक साधारण .txt फ़ाइल होती है। इसे किसी भी एडिटर में खोलें, मॉडल द्वारा गलत सुने गए नामों या तकनीकी शब्दों को ठीक करें, और जहाँ आवश्यकता हो वहाँ पेस्ट करें। व्यक्तिवाचक नाम और दुर्लभ संक्षिप्त रूप सबसे आम चीज़ें हैं जिन्हें जाँचना चाहिए।