Datenschutz an erster Stelle
Hochgeladene Dateien werden innerhalb von zwei Stunden automatisch und dauerhaft gelöscht.
Automatische Löschung

Diktieren Sie Diktate, Kommentare, Vorlesungsnotizen, Interviewantworten oder einen kurzen Voice-over-Text direkt im Browser, oder laden Sie eine Aufnahme hoch, und erhalten Sie die gesprochenen Worte als Klartextdatei (.txt, UTF 8). Die Transkription basiert auf Whisper, dem Open-Source-Modell zur Spracherkennung, und läuft auf unseren eigenen Servern – in rund 100 automatisch erkannten Sprachen.
Die Seite kombiniert einen Recorder im Browser mit einem GPU basierten Transkriptions-Backend. Die Aufnahme erfolgt über die in Chrome, Firefox, Edge und Safari integrierte MediaRecorder-Schnittstelle; die Spracherkennung übernimmt Whisper, das von OpenAI veröffentlichte Open-Source-Modell, das auf unserer eigenen Hardware statt über eine API eines Drittanbieters läuft.
Klicken Sie auf „Mit Ihrem Mikrofon aufnehmen“, erlauben Sie einmal den Zugriff und sprechen Sie. Ein Timer und eine Pegelanzeige bestätigen, dass Audio empfangen wird. Oder laden Sie eine vorhandene Aufnahme hoch – Sprachmemos von jedem Smartphone sind geeignet.
Hören Sie sich die Aufnahme im Dialog an. Aktivieren Sie bei Interviews und Meetings „Mehrere Sprecher erkennen“ (markiert, wer spricht, dauert aber deutlich länger). Starten Sie anschließend die Transkription.
Der Fortschritt wird angezeigt, während das Modell arbeitet; einige Minuten Sprache werden in der Regel in deutlich unter einer Minute verarbeitet. Laden Sie auf der Ergebnisseite eine Klartextdatei (.txt, UTF 8) herunter.
Whisper wurde mit 680.000 Stunden mehrsprachigem Audiomaterial trainiert und verarbeitet Akzente, Hintergrundgeräusche und Fachvokabular deutlich besser als die Diktierprogramme von vor einigen Jahren. Die Sprache wird automatisch erkannt.
Bei Gesprächen kennzeichnet die optionale Sprechererkennung Sprecherwechsel im Transkript. Sie verdoppelt die Verarbeitungszeit ungefähr und ist daher standardmäßig deaktiviert.
Das Transkript wird als einfache UTF 8 Textdatei mit normaler Zeichensetzung und Absatzumbrüchen gespeichert. Sie lässt sich in jedem Editor, Textverarbeitungsprogramm oder jeder Notiz-App öffnen und überall einfügen.
Kein Konto, kein Wasserzeichen, kein Testlimit. Die Aufnahme bleibt auf Ihrem Gerät, bis Sie die Verarbeitung bestätigen. Anschließend werden Audio und Transkript automatisch gelöscht.
Entwickelt von Ingenieuren mit mehr als 10 Jahren Erfahrung in groß angelegter Infrastruktur, Datensystemen und wissenschaftlichem Rechnen. Entwickelt für reale Audio-Workflows, bei denen Privatsphäre, zuverlässige Verarbeitung und praktische Benutzerfreundlichkeit zählen.
Hochgeladene Dateien werden innerhalb von zwei Stunden automatisch und dauerhaft gelöscht.
Bewertet mit 5 Sternen auf Trustpilot für Geschwindigkeit, Zuverlässigkeit und einfache Bedienung.
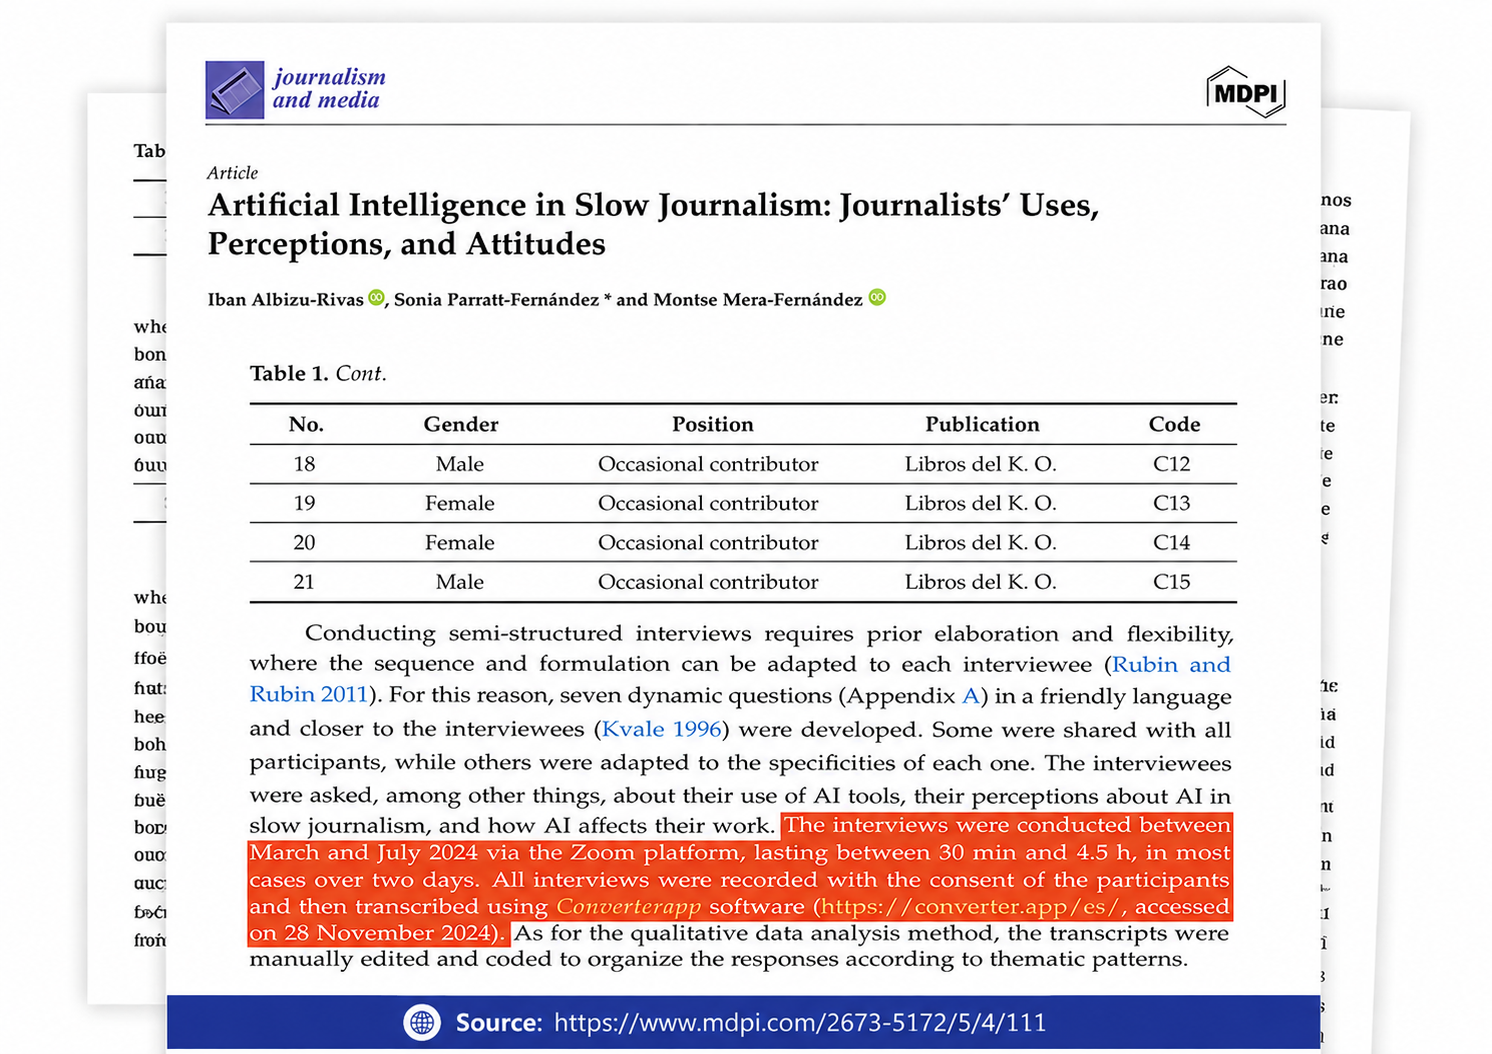
In veröffentlichter Forschung erwähnt und für Interview-Transkription und qualitative Datenanalyse verwendet.
Ihr Browser zeichnet das Mikrofon als Opus-Audio (Chrome, Firefox, Edge) oder AAC (Safari) auf und speichert die Aufnahme im Arbeitsspeicher. Nach Ihrer Bestätigung wird die Datei über HTTPS auf einen unserer Transkriptionsserver hochgeladen.
Dort dekodiert ffmpeg die Audiodatei, und Whisper – ein Open-Source-Modell zur Spracherkennung – wandelt sie in einem Durchgang in Text um, einschließlich Zeichensetzung und Satzumbrüchen. Ist die Sprechererkennung aktiviert, teilt ein Diarisierungsmodell die Audiodatei zunächst nach Sprechern auf und versieht das Transkript entsprechend mit Anmerkungen.
Das Transkript wird als einfache UTF 8 Textdatei mit normaler Zeichensetzung und Absatzumbrüchen gespeichert. Dadurch lässt es sich in jedem Editor, Textverarbeitungsprogramm oder jeder Notiz-App öffnen und überall einfügen. Auf der Ergebnisseite können Sie es herunterladen; die Audiodatei und das Transkript werden anschließend automatisch gelöscht.
Die Spracherkennung ist nur so gut wie die Audioqualität. Drei Faktoren machen den größten Unterschied: Abstand, Störgeräusche und Überlappungen. Halten Sie das Mikrofon 10–20 cm von Ihrem Mund entfernt; ein nah gehaltenes Smartphone ist besser als ein Laptop am anderen Ende des Tisches. Schalten Sie Ventilatoren aus, schließen Sie das Fenster und vermeiden Sie Räume mit starkem Hall.
Sprechen Sie in normalem Tempo und beenden Sie Sätze – das Modell nutzt den Kontext. Unvollständige Sätze und Füllwörter führen daher zu schlechteren Texten als etwas langsameres, vollständiges Sprechen. Bitten Sie bei Interviews darum, nicht gleichzeitig zu sprechen; überlappende Sprache ist für jede Spracherkennung der schwierigste Fall.
Hören Sie sich die Vorschau an, bevor Sie beginnen. Wenn die Pegelanzeige sich kaum bewegt oder ständig den Maximalwert erreicht, nehmen Sie lieber erneut auf, statt zu hoffen, dass das Transkript korrekt wird.
Dieses Tool wird von Lehrkräften, Podcastern, Journalisten und allen genutzt, die ihre Gedanken schneller laut aussprechen als auf der Tastatur tippen: um eine E-Mail oder einen Artikel per Sprache zu entwerfen, Besprechungsprotokolle festzuhalten, eine Vorlesung oder Sprachnotiz in durchsuchbare Notizen umzuwandeln, Interviewantworten für Forschungszwecke zu transkribieren und eine lesbare Version einer Sprachnachricht zu erhalten, die gerade nicht abgespielt werden kann.
Da Whisper die Sprache automatisch erkennt, funktioniert dieselbe Seite ohne Einstellungen für ein deutsches Diktat, eine spanische Sprachnotiz oder eine englische Vorlesung. Das Transkript wird nicht übersetzt, sondern in der gesprochenen Sprache erstellt.
Für Audiodateien, die bereits vorliegen – Podcasts, Vorlesungen, Anrufe – verwenden die Audio-zu-Text- und MP3 zu Text Konverter auf dieser Website dieselbe Engine mit denselben Optionen.
Es übersetzt nicht: Transkripte werden in der gesprochenen Sprache erstellt. Es erzeugt keine Untertitel-Zeitmarken – für SRT- oder VTT Dateien verwenden Sie die Untertitel-Konverter auf dieser Website. Es erkennt Sprecher nicht anhand ihres Namens, sondern nur einen Sprecherwechsel, wenn die Sprechererkennung aktiviert ist. Außerdem kann es keine Wörter wiederherstellen, die in der Aufnahme nicht hörbar sind.
Eigennamen, Produktnamen und seltene Abkürzungen sind die häufigsten Fehlerquellen; bei einer sauberen Aufnahme genügt meist ein kurzes Durchlesen des Ergebnisses mit besonderem Augenmerk darauf.
Bei einer klaren Aufnahme mit nur einer sprechenden Person erkennt Whisper in wichtigen Sprachen einschließlich Zeichensetzung in der Regel deutlich über 90 % der Wörter korrekt. Bei starken Hintergrundgeräuschen, mehreren sich gegenseitig überlagernden Stimmen, sehr leisen Audiodateien oder ausgeprägten Dialekten sinkt die Genauigkeit – die folgenden Tipps für Aufnahmen helfen mehr als jede Einstellung.
Whisper erkennt rund 100 Sprachen und wählt die Sprache automatisch anhand der ersten Sekunden der Audiodatei aus, sodass keine Einstellung erforderlich ist. Aufnahmen mit mehreren Sprachen werden in der vorherrschenden Sprache transkribiert. Das Transkript wird in der gesprochenen Sprache erstellt und nicht übersetzt.
Nein. Der Rekorder speichert die Audiodaten in Ihrem Browser, bis Sie die Schaltfläche im Dialogfeld drücken. Wenn Sie abbrechen oder den Tab schließen, wird nichts gesendet. Hochgeladene Dateien und Transkripte werden nach der Verarbeitung automatisch gelöscht.
Der Recorder im Browser stoppt nach 30 Minuten; hochgeladene Dateien können länger sein. Die Verarbeitungszeit steigt mit der Länge der Audiodatei, und die Sprechererkennung benötigt zusätzlich etwa die gleiche Zeit.
Vor der Transkription wird eine Sprecherdiarisierung durchgeführt und bei jedem Sprecherwechsel eine Markierung eingefügt. Verwenden Sie diese Funktion für Interviews, Besprechungen und Podcasts; lassen Sie sie bei Diktaten und Sprachnotizen deaktiviert, da sie dort nur die Wartezeit verlängert.
Ja – das Ergebnis ist eine einfache .txt-Datei. Öffnen Sie sie in einem beliebigen Editor, korrigieren Sie Namen oder Fachbegriffe, die das Modell falsch verstanden hat, und fügen Sie den Text dort ein, wo Sie ihn benötigen. Eigennamen und seltene Abkürzungen sollten Sie am häufigsten überprüfen.